Les RFC (Request For Comments) sont les documents de référence de l'Internet. Produits par l'IETF pour la plupart, ils spécifient des normes, documentent des expériences, exposent des projets...
Leur gratuité et leur libre distribution ont joué un grand rôle dans le succès de l'Internet, notamment par rapport aux protocoles OSI de l'ISO organisation très fermée et dont les normes coûtent cher.
Je ne tente pas ici de traduire les RFC en français (un projet pour cela existe mais je n'y participe pas, considérant que c'est une mauvaise idée), mais simplement, grâce à une courte introduction en français, de donner envie de lire ces excellents documents. (Au passage, si vous les voulez présentés en italien...)
Le public visé n'est pas le gourou mais l'honnête ingénieur ou l'étudiant.
RFC 10050: Protocol-Specific Profiles for JSContact
Date de publication du RFC : Septembre 2026
Auteur(s) du RFC : R. Stepanek (Fastmail), M. Loffredo (IIT-CNR)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF calext
Première rédaction de cet article le 24 septembre 2026
La norme JSContact décrit un modèle de données et un format pour stocker des informations de contact sur une entité (personne physique ou morale). Elle est riche, avec beaucoup d'informations dont toutes les applications n'ont pas forcément besoin. Ce RFC normalise la notion de profil : un profil est une spécialisation de JSContact, indiquant les éléments obligatoires et les autres. Un nouveau registre IANA stocke les profils existants.
JSContact est normalisé dans le RFC 9553. Il peut servir par exemple comme modèle de données et format pour un carnet d'adresses, ou dans des protocoles d'accès à l'information sur les contacts d'un objet enregistré, comme RDAP (RFC 9083). On peut échanger du JSContact avec des protocoles comme CardDAV (RFC 6352) ou JMAP (RFC 9610). JSContact vise à remplacer vCard (RFC 6350) et sa déclinaison jCard (RFC 7095), complexes et difficiles à traiter.
Mais JSContact a ses propres complications ; comme il a un modèle de données riche, pour pouvoir gérer tous les cas prévisibles, une mise en œuvre de JSContact doit traiter des données même quand l'application n'en a pas l'usage (sans compter les problèmes de vie privée que peut poser cette absence de minimisation des données). Le RFC 9553 permet d'ignorer certaines données, mais uniquement celles d'extension de JSON, pas les données du cœur.
La solution de notre RFC est de permettre la définition de profils, un profil étant une définition de ce qui est nécessaire dans un objet JSContact. Ainsi, une application qui n'a besoin que de peu de données peut utiliser JSContact au lieu de définir son propre format. Le registre central permettra de trouver et de référencer facilement les profils. (Aujourd'hui, aucun n'est enregistré.)
Un profil est donc un ensemble d'éléments JSContact, stocké dans le registre IANA. Il a un nom (restreint à ASCII). Notez bien qu'un même objet JSContact peut être valide selon plusieurs profils et c'est pour cela que le profil n'est pas affiché dans l'objet.
Un profil liste plusieurs propriétés, qui ont notamment un nom, un contexte (à quel type d'objets s'applique le profil), des restrictions sur les attributs… Par exemple, cette propriété :
 Property Name: kind Property Context: Card Restricted Enum
  Values: individual,org
s'applique aux objets
Card et dit que kind (RFC 9553, section 2.1.4) ne peut être que
individual ou org (et pas,
comme normalement en JSContact, group,
application, etc).
Je l'ai dit, le registre actuel est vide donc, pour avoir des exemples, il faut regarder les annexes A.1, A.3 et A.4 (profil) ainsi que A.2 (objet JSContact correspondant à ce profil) du RFC. Pour ajouter des profils au registre, la politique à suivre (RFC 8126) est « Spécification nécessaire ».
L'article seul
RFC 10049: Roughtime: A Protocol for Rough Time Synchronization
Date de publication du RFC : Octobre 2026
Auteur(s) du RFC : W. Ladd (Akamai
Technologies), M. Dansarie
(Netnod)
Expérimental
Réalisé dans le cadre du groupe de travail IETF ntp
Première rédaction de cet article le 7 octobre 2026
Ce nouveau protocole de synchronisation d'horloges, Roughtime est, officiellement, encore expérimental. Deux de ses buts essentiels sont la possibilité d'une synchronisation sécurisée (avec de la cryptographie, donc), même quand le client n'a aucune idée de l'heure et du jour, et un moyen de signaler les erreurs et problèmes rencontrés. Il concernera notamment les objets connectés qui, souvent, n'ont pas de batterie pour garder l'heure pendant un arrêt.
Si vous connaissez NTP (RFC 5905), vous savez qu'il n'offre pas de solution à ces deux problèmes. Roughtime est donc une alternative à NTP.
La synchronisation des horloges est un problème très ancien sur l'Internet (cf. RFC 738). Elle est à la fois cruciale, notamment en sécurité, et très difficile à réaliser. Pour comprendre son importance en sécurité, pensez par exemple à l'estampillage de journaux. Ou aux signatures DNSSEC. Ou à TOTP (RFC 6238). Ou encore à la vérification qu'un certificat n'est pas expiré. Mais c'est justement aussi cela qui rend difficile de la sécuriser. NTP a un mécanisme de sécurité, NTS, normalisé dans le RFC 8915, mais qui dépend d'un certificat, donc d'avoir l'heure correcte. C'est un intéressant problème d'œuf et de poule : pour vérifier le certificat du serveur de temps, vous avez besoin de connaitre l'heure, justement ce que vous vouliez demander au serveur (section 6 du RFC).
Roughtime, spécifié dans ce RFC 10049, résoud le problème en partant d'une liste de serveurs et de leurs clés publiques. Celles-ci sont censées durer assez longtemps pour que, dans la liste des serveurs, il y en ait plusieurs qui soient correctes. En prime, l'utilisation de réponses signées par les serveurs Roughtime permet à un client de prouver à un tiers qu'un serveur est malveillant (ou complètement déconnant ; on ne peut pas distinguer les deux cas). Le client obtient cette preuve en chainant les réponses de plusieurs serveurs. J'insiste : si on n'utilise qu'un seul serveur Roughtime, le client ne peut pas être sûr que l'heure obtenue est correcte. La sécurité ne vient que lorsqu'on a « suffisamment » de serveurs. (Évidemment, s'ils sont tous malveillants ou déconnants, on est fichu. Comme dit lors d'une discussion IETF, « Ideally, you would use 3 servers run by 3 different organizations using 3 different software implementations running on 3 different operating systems in 3 different well guarded buildings in 3 different countries... ».) Cette possibilité de prouver à un tiers qu'un des serveurs ne servait pas l'heure correcte est une importante différence avec un autre concurrent de NTP, Khronos (RFC 9523).
Ce RFC décrit le format des paquets et le protocole mais pour que Roughtime sorte de son statut expérimental, il faudra aussi déployer un écosystème de serveurs et un mécanisme pour obtenir une liste (avec les clés, souvenez-vous). Aucune méthode n'est prévue pour l'instant pour changer les clés, il faudra donc vraiment qu'elles durent longtemps, ou que l'objet connecté puisse facilement mettre à jour de manière sécurisée sa liste de serveurs.
La section 3 du RFC décrit le protocole en termes généraux. Signer les réponses n'est pas suffisant car il faut aussi que la réponse dépende de la requête du client (pour qu'il s'assure qu'on ne lui serve pas une vieille réponse rassise) et qu'on puisse la chainer avec celle des autres serveurs (via le classique arbre de Merkle), pour qu'un tiers puisse repérer le serveur qui ne répond pas correctement. S'il n'y a qu'un serveur utilisé, le client peut tout juste vérifier que le message est correctement signé, et correspond à la question (celle-ci inclut un numnique) mais s'il y en a plusieurs, le client peut les comparer et repérer un serveur qui est trop à l'écart (que ce soit par erreur ou par malveillance, en général, on ne peut pas distinguer les deux). Une fois le serveur anormal repéré, on peut le signaler sur un forum, le faire virer des listes de serveurs qui circulent, etc.
La section 4 décrit le format des messages. Parmi les points à noter, la notion d'étiquette (tag). Les valeurs transportées sont toutes étiquetées, chaque étiquette étant sur quatre octets, en général choisis pour être une valeur en ASCII. NONC va ainsi indiquer que la valeur qui suit est le numnique (nonce), VER (avec un octet nul à la fin) indique la version (actuellement version 1), etc. Les étiquettes connues figurent dans un registre IANA et on peut en ajouter selon la politique « Spécification nécessaire » du RFC 8126.
Autre notion cruciale, les valeurs temporelles (timestamp) sont un entier sur 64 bits, indiquant le nombre de secondes depuis le 1 janvier 1970. Le message complet est composé d'un nombre magique (0x4d49544847554f52, ce qui fait "ROUGHTIM"), du nombre de valeurs, d'une liste de décalages des valeurs, d'une liste d'étiquettes, puis des valeurs. Les deux listes sont triées selon l'ordre des étiquettes. La première valeur a pour décalage zéro.
Le message est ensuite transmis en UDP (avec du remplissage obligatoire pour éviter les attaques avec amplification, section 9.7 du RFC). L'algorithme cryptographique est forcément Ed25519, décrit dans le RFC 8032. Il n'y a pas d'agilité cryptographique - RFC 7696, il faudra changer de version du protocole pour, par exemple, passer à la cryptographie post-quantique (section 9.5). Dans une requête, les étiquettes VER (version du protocole), NONC (le numnique du client, qui doit évidemment être aussi imprédictible que possible, cf. RFC 4086) et TYPE (0 pour une requête) sont obligatoires. On peut y ajouter SRV, qui indique la clé publique que le client compte utiliser (cela permet au serveur, entre autres, de sélectionner la bonne clé si on en a plusieurs, mais aussi de voir qu'un client a toujours une vieille clé).
La réponse a les étiquettes NONC (celui qui avait été envoyé par le client), TYPE (1 pour une réponse), SIG (la signature du message), PATH (des valeurs de l'arbre de Merkle), CERT (un certificat) et SREP (la partie utile de la réponse). La valeur associée à l'étiquette SREP est elle-même un message Roughtime avec notamment les étiquettes MIDP (l'heure sur le serveur, c'est-à-dire l'information principale pour le client), RADI (une estimation de la précision de l'heure, en secondes) et ROOT (la racine de l'arbre de Merkle, qui sera utilisé si on interroge plusieurs serveurs, cf. section 5.3).
On peut noter qu'il n'existe pas de réponse pour une requête erronée (pas de FORMERR comme dans le DNS ou de Kiss o' Death comme dans NTP). L'expérience de NTP (section 7.4 du RFC 5905, section 5.4 du RFC 8633 et section 8.3 et 8.7 du RFC 8915) est que cela facilite trop certaines attaques par déni de service en faisant croire qu'un serveur a un problème.
Pour éviter l'ossification du protocole, la section 7 du RFC demande de graisser (RFC 9170) les réponses en envoyant de temps en temps des réponses invalides (absence d'étiquettes obligatoires, par exemple, présence d'étiquettes non définies et surtout heures délibérement incorrectes mais avec des signatures invalides ; un client bien fait ignorera ces réponses, les autres se feront tromper).
Côté client, maintenant, le protocole prévoit que le client
vérifie les signatures et signale (par un moyen non normalisé) les
serveurs qui s'écarteraient trop des autres. La section 8.4 décrit
un format en JSON pour produire des rapports, au type
application/roughtime-malfeasance+json (avec un
exemple dans l'annexe B) mais, pour l'instant, il n'y a pas
grand'chose de spécifié et encore moins de déployé.
Notez que, si les réponses sont signées, Roughtime ne fournit en revanche aucune confidentialité.
Sur ma machine au logiciel pas tout à fait récent, Wireshark ne connait pas encore Roughtime mais, quand on analyse un paquet, on voit bien la liste des étiquettes :
Frame 10: 434 bytes on wire (3472 bits), 434 bytes captured (3472 bits)
…
User Datagram Protocol, Src Port: 2002, Dst Port: 47639
Data (392 bytes)

0000  52 4f 55 47 48 54 49 4d 7c 01 00 00 07 00 00 00   ROUGHTIM|.......
0010  40 00 00 00 44 00 00 00 64 00 00 00 64 00 00 00   @...D...d...d...
0020  a8 00 00 00 40 01 00 00 53 49 47 00 56 45 52 00   ....@...SIG.VER.
0030  4e 4f 4e 43 50 41 54 48 53 52 45 50 43 45 52 54   NONCPATHSREPCERT
0040  49 4e 44 58 73 d4 d3 56 32 f7 d1 03 28 31 35 bf   INDXs..V2...(15.
0050  18 14 ea 6e 62 74 99 58 ca b2 85 bf 1f 0b ca a1   ...nbt.X........
0060  4e 06 1c 4a ea 0b e0 9c 93 12 5b 7d 79 23 16 c3   N..J......[}y#..
0070  32 d9 41 d9 b0 94 5b 68 c0 e3 f1 c3 61 ab 00 6f   2.A...[h....a..o
0080  58 a8 d9 0c 0b 00 00 80 ac 90 f3 d2 69 b9 f8 d6   X...........i...
0090  7a 0d b7 37 42 e3 27 ab ed e3 fb d2 e8 41 f9 25   z..7B.'......A.%
00a0  75 de be 60 0a d6 59 80 03 00 00 00 04 00 00 00   u..`..Y.........
00b0  0c 00 00 00 52 41 44 49 4d 49 44 50 52 4f 4f 54   ....RADIMIDPROOT
00c0  03 00 00 00 3c 2c c6 6a 00 00 00 00 28 68 0c 3e   ....<,.j....(h.>
00d0  99 9c 8d c3 1c 86 9b 1f b9 05 4b 3d a5 92 0d 4c   ..........K=...L
00e0  48 4f a0 7c 16 ae e4 1e 0b 24 2e d1 02 00 00 00   HO.|.....$......
00f0  40 00 00 00 53 49 47 00 44 45 4c 45 cc 05 f4 6c   @...SIG.DELE...l
0100  56 46 12 eb 4d 45 47 c9 77 21 f4 9b 78 8f 46 2c   VF..MEG.w!..x.F,
0110  fa e1 08 8b 49 40 2e 70 e2 c3 15 f1 fe 2e 50 ab   ....I@.p......P.
0120  00 ab 77 18 3e f2 e0 56 7b 41 9a 39 78 de 4a e4   ..w.>..V{A.9x.J.
0130  aa 8d bf c8 79 b3 f9 86 75 8a 18 0f 03 00 00 00   ....y...u.......
0140  20 00 00 00 28 00 00 00 50 55 42 4b 4d 49 4e 54    ...(...PUBKMINT
0150  4d 41 58 54 b4 f2 07 3c f9 a5 f4 f0 d2 e5 03 51   MAXT...<.......Q
0160  1a cb b0 31 2f e3 cd 83 b7 14 ef 64 eb bb 9c 3b   ...1/......d...;
0170  4c 69 3a ea dc 8e c5 6a 00 00 00 00 5c e0 c6 6a   Li:....j....\..j
0180  00 00 00 00 00 00 00 00                           ........
    Data [truncated]: 524f55474854494d7c0100000700000040000000440000006400000064000000a80000004001000053494700564552004e4f4e4350415448535
2455043455254494e445873d4d35632f7d103283135bf1814ea6e62749958cab285bf1f0bcaa14e061c4aea0be09c93125b7d79231
    [Length: 392]
Voyons maintenant les mises en œuvre concrètes de ce protocole, côté client et côté serveur. D'abord, un avertissement : le RFC vient de sortir, le projet de norme a eu plusieurs itérations et vous trouverez donc en ligne divers programmes qui n'interagissent pas toujours entre eux (par exemple, le logiciel client de Cloudflare ne fonctionne pas avec le serveur public de Cloudflare). Il faudra donc attendre un peu que tout soit d'équerre. En attendant, jouons un peu. D'abord, le logiciel de Cloudflare, écrit en Go (vous pouvez aussi lire leur documentation) :
% git clone https://github.com/cloudflare/roughtime.git
% cd roughtime
% cd cmd/getroughtime
% go build main.go
% ./main
Either provide a configuration via -config or an address via -ping
Ah, c'est logique, rappelez-vous ce que j'ai écrit sur la liste de
serveurs (et leurs clés, cf. sections 8.1 et 8.3 du
RFC). getroughtime sait utiliser une liste écrite en JSON. Le RFC décrit le
format dans sa section 8.3, et on utilise le
type
application/roughtime-server+json si on la
distribue en ligne. Un exemple figure dans l'annexe A. Il y a une
liste fournie dans le logiciel, utilisons-la :
% ./main -config ../../ecosystem.json
skipped Cloudflare-Roughtime-2: protocol: response is missing NONC tag
skipped int08h-Roughtime: no reply
skipped roughtime.se: no reply
time.txryan.com: 2026-10-06 09:36:47 +0000 UTC ±3s (in 96ms)
Delta: -741ms
Bon, plusieurs des serveurs ne répondent pas, ou pas correctement selon les clients (ma remarque ci-dessus à propos des différentes versions qui trainent). Mais le dernier marche, et on a bien l'heure. Le même logiciel contient aussi un serveur de test :
% cd ../testserver
% go build main.go
% ./main
main.go:64: Root public key: zFVzPprRDxDOMdsrifp+/XPkVkDEhllv6QDJxOWWYd0=
Le serveur tourne (par défaut, sur
127.0.0.1:2002). Notez que le
port officiellement enregistré
à l'IANA est désormais 5319. Et le serveur nous affiche sa
clé. Essayons en indiquant cette clé :
% cd ../getroughtime
% ./main -ping localhost:2002 -pubkey zFVzPprRDxDOMdsrifp+/XPkVkDEhllv6QDJxOWWYd0=
Ping response: 2026-10-06 11:37:57.754243 +0200 CEST ±1s (in 1ms)
Parfait, tout va bien. Si on avait indiqué une mauvaise clé :
% ./main -ping localhost:2002 -pubkey kMe//FBOFOwPXjx8NYjPtkdlH94IoxAX98RDsiVXcEc=
Ping error: protocol: invalid delegation signature
Le client vérifie donc bien les signatures du serveur. Essayons avec un autre logiciel, écrit en C :
% git clone https://github.com/nahojkap/craggy.git
% cd craggy
% cmake -E make_directory ./build
% cmake -S . -B ./build/ -DCRAGGY_WITH_ORLP_ED25519_BINDINGS=ON
% cd build
% make
Le client ne fonctionne pas avec le serveur de test de Cloudflare (qui meurt avec « main.go:97: Error while handling request: no version in common: [] ») mais il marche avec au moins un serveur public :
% ./cli/craggy-cli -h  time.txryan.com:2002 -k iBVjxg/1j7y1+kQUTBYdTabxCppesU/07D4PMDJk2WA=

Received reply in 105898μs. (105ms)
Current time is 1791281389ms from the epoch, ±3s
System clock differs from that estimate by -796785μs. (-796ms)
Il existe aussi d'autres mises en œuvre que je n'ai pas testées,
chez
Google en Go, une autre en C
et une
dernière, en Clojure. Si vous cherchez
des serveurs publics pour tester, vous avez une
liste (pas à jour…) dans le code de Cloudflare. Ou bien vous
en trouvez quelque part sur le réseau, par exemple le serveur expérimental de SIDN. Je
copie la configuration qu'ils indiquent, je l'édite pour changer la
version en IETF-Roughtime (car le client testé ne
connait pas encore la version 1) et ça marche avec le logiciel de
Cloudflare :
% ./main -config /tmp/sidn.json
TimeNL-Roughtime: 2026-10-07 17:06:30 +0200 CEST ±3s (in 24ms)
Delta: -658ms
Autres lectures :
- L'explication de Cloudflare et la documentation du logiciel,
- une courte explication claire des buts du protocole par un des auteurs du RFC et une présentation qu'il avait faite au RIPE pendant le développement du protocol,
- la vidéo d'une autre présentation du projet,
- le résultat des tests du protocole à un hackathon de l'IETF en 2024,
L'article seul
RFC 10042: Post-Quantum/Traditional Hybrid Key Exchange with the Module-Lattice-Based Key-Encapsulation Mechanism for Use in SSH
Date de publication du RFC : Août 2026
Auteur(s) du RFC : P. Kampanakis (AWS), D. Stebila
(University of Waterloo), T. Hansen
(AWS)
Pour information
Réalisé dans le cadre du groupe de travail IETF sshm
Première rédaction de cet article le 31 août 2026
Tout le monde (et son chat) se met à la cryptographie post-quantique en ce moment et plus précisément à des systèmes hybrides, c'est-à-dire utilisant à la fois un algorithme traditionnel (comme ECDH) et un algorithme post-quantique (comme ML-KEM). Ce RFC décrit l'échange de clés avec un système hybride dans le protocole SSH.
Au début d'une connexion SSH (RFC 4251, section 1), les deux parties qui communiquent procèdent en effet à un échange de clés (section 7 du RFC 4253) afin de parvenir à un accord sur la clé partagée qui sera utilisée pour chiffrer la communication. Jusqu'à récemment, cet échange de clés était fait en utilisant un algorithme reposant sur les courbes elliptiques (RFC 5656 et RFC 8731), algorithme qui est vulnérable aux futurs calculateurs quantiques. Si des calculateurs quantiques réellement utilisables (les CRQC, Cryptographically Relevant Quantum Computers) apparaissent un jour, l'ancien algorithme devra être abandonné. Et on ne peut pas attendre pour voir si des CRQC deviennent réellement disponibles : des attaquants sont peut-être aujourd'hui en train d'enregistrer des sessions SSH, afin de les décrypter plus tard lorsqu'on aura enfin des CRQC (RFC 9958, section 1). Bref, il vaut mieux passer à des algorithmes post-quantiques dès maintenant.
Mais les algorithmes post-quantiques existants ne sont pas forcément sûrs face à la cryptanalyse ; on manque de recul à ce sujet. D'où l'idée de systèmes hybrides (RFC 9794), ou PQ/T (pour PostQuantum/Traditional) combinant algorithme post-quantique et algorithme traditionnel, et obligeant l'attaquant à casser les deux s'il veut décrypter la communication. (Si vous voulez creuser la question de la sécurité des systèmes hybrides, regardez « Security of Hybrid Key Encapsulation » et « Security of Hybrid Key Establishment using Concatenation ».) C'est ce genre de système que normalise notre RFC. Il est sûr face à un attaquant actif, même si ce dernier dispose d'un calculateur quantique ou bien s'il a trouvé une faille dans l'algorithme post-quantique.
Plus précisément, ce RFC va utiliser l'algorithme post-quantique ML-KEM avec un choix d'algorithmes traditionnels.
La section 2 du RFC décrit concrètement l'échange de clés avec le
système hybride (relire les RFC 4251 et RFC 4253 peut être utile). Le client SSH, au lieu
de commencer par SSH_MSG_KEXDH_INIT (RFC 4253) ou
SSH_MSG_KEX_ECDH_INIT (RFC 5656), envoie un message
SSH_MSG_KEX_HYBRID_INIT (valeur 30 dans le
protocole) qui contient la concaténation des deux clés du client. Et
la réponse, au lieu de SSH_MSG_KEXDH_REPLY ou
SSH_MSG_KEX_ECDH_REPLY sera un
SSH_MSG_KEX_HYBRID_REPLY (valeur 31 dans le
protocole) contenant la concaténation des deux clés du serveur. Le
choix du mécanisme hybride utilisé est indiqué dans le message
SSH_MSG_KEXINIT (RFC 4253, section 7.1) et peut valoir
mlkem768nistp256-sha256,
mlkem1024nistp384-sha384 ou
mlkem768x25519-sha256 (désormais enregistrés
à l'IANA). Rappelez-vous qu'on parle d'échange de clés (symétriques), pas
d'authentification, la réponse
SSH_MSG_KEX_HYBRID_REPLY contient aussi la clé
publique du serveur, celle qui sert à vérifier qu'on parle au bon
serveur, mais celle-ci n'est pas concernée par ce RFC.
Le mécanisme hybride va nous donner deux secrets partagés, un pour chaque algorithme (le post-quantique et le traditionnel) et le secret qui servira (après dérivation) de clé pour le chiffrement symétrique est la concaténation de ces deux secrets (c'est très proche de ce que fait TLS, dans le RFC 9954).
Un problème classique de la cryptographie post-quantique est la taille des clés, bien plus importante qu'avec les algorithmes traditionnels. (L'hybride est même un tout petit peu plus grand, avec la clé traditionnelle.) SSH a des limites de taille (section 6.1 du RFC 4253) mais les algorithmes spécifiés dans notre RFC ne les atteignent pas.
La section 6 du RFC détaille les conséquences de ce schéma hybride sur la sécurité. Elle conseille par exemple d'utiliser X25519 (RFC 8731) plutôt que les courbes NIST comme P256, pour sa rapidité et sa meilleure résistance aux attaques par canal auxiliaire, sauf si on veut de la conformité plutôt que de la sécurité et qu'on doit utiliser les courbes NIST.
Côté mise en œuvre de ce système hybride,
OpenSSH le connait (ssh -Q
kex pour avoir la liste des algorithmes connus)
et, depuis la version
10.4, « the hybrid post-quantum algorithm
mlkem768x25519-sha256 is now used by default for key
agreement ». Par exemple :
% ssh -v something.bortzmeyer.org
debug1: OpenSSH_10.4p1, OpenSSL 3.6.3 9 Jun 2026
…
debug1: kex: algorithm: mlkem768x25519-sha256
debug1: kex: host key algorithm: ssh-ed25519
debug1: kex: server->client cipher: chacha20-poly1305@openssh.com MAC: <implicit> compression: none
debug1: kex: client->server cipher: chacha20-poly1305@openssh.com MAC: <implicit> compression: none
debug1: expecting SSH2_MSG_KEX_ECDH_REPLY
debug1: SSH2_MSG_KEX_ECDH_REPLY received
…
Hmmm, ça aurait dû être
SSH_MSG_KEX_HYBRID_REPLY, bizarre…
L'article seul
RFC 10037: Registration Data Access Protocol (RDAP) Extension for DNS Time-to-Live (TTL) Values
Date de publication du RFC : Août 2026
Auteur(s) du RFC : G. Brown (ICANN)
Chemin des normes
Première rédaction de cet article le 29 août 2026
Puisque le RFC 9803 étend le protocole d'avitaillement EPP pour ajouter des TTL spécifiques aux noms de domaine enregistrés, il était logique que le protocole d'interrogation RDAP permette d'obtenir cette information. C'est ce que permet l'extension normalisée dans ce nouveau RFC.
L'extension est simple, et le RFC court. RDAP permet d'obtenir des informations, structurées en JSON, sur divers objets enregistrés, comme les noms de domaine. Ces réponses (RFC 9083) peuvent inclure la valeur d'enregistrements DNS de type DS, NS, A ou AAAA mais, jusqu'à présent, pas leurs TTL (section 5 du RFC 9499, sur ce concept de TTL). Ce n'était pas trop grave tant que la quasi-totalité des registres imposaient le même TTL, choisi par eux, à toutes les données. Maintenant que le RFC 9803 normalise un moyen pour le client de choisir son TTL, cette limitation de RDAP était plus gênante.
Donc, concrètement, le serveur RDAP qui gère cette extension doit
ajouter une propriété ttl0_data aux objets de
type domaine (RFC 9083, section 5.3) et
serveur de noms (RFC 9083, section 5.2). Cette
propriété est un objet JSON comportant les membres
values et (facultativement)
remarks. values est un
dictionnaire indexé par le type
d'enregistrement, et dont les valeurs sont le TTL en secondes. C'est
le TTL tel qu'enregistré dans la base de données du registre, et pas
celui que verra une requête DNS auprès de votre résolveur, celui-ci étant la durée
restante dans la mémoire du résolveur. Voici l'exemple du RFC :
{
  "objectClassName": "domain",
  "rdapConformance": ["rdap_level_0", "ttl0"],
  "ldhName": "domain.example",
  "ttl0_data": {
    "values": {
      "NS": 3600,
      "DS": 300
    },
    "remarks": [
      {
        "description": [
          "For more information about the .example",
          " registry policy relating to DS record TTL changes,",
          "see https://domain.example/policy.html"
        ]
      }
    ]
  }
}
Et pour un serveur de noms enregistré (cf. RFC 5732) :
 {
  "objectClassName": "nameserver",
  "rdapConformance": ["rdap_level_0", "ttl0"],
  "ldhName": "ns1.domain.example",
  "ttl0_data": {
    "values": {
      "A": 86400,
      "AAAA": 86400
    },
    "remarks": [
      {
        "description": [
          "The .example registry does not permit TTL ",
          "values for nameservers to be changed."
        ]
     }
   ]
  }
}
Notez aussi le ttl0 dans le tableau
rdapConformance pour indiquer que le serveur
RDAP connait cette extension.
L'extension est désormais enregistrée à l'IANA. Quels logiciels la gèrent ? La bibliothèque RDAP de l'ICANN ainsi que la bibliothèque Perl Net::RDAP et son client rdapper.
Petit rappel important au passage : la section 5.2 du RFC 2181 impose que le TTL s'applique à un ensemble d'enregistrements (RRset, pour Resource Record Set) pas à un seul enregistrement. Ainsi, pour un ensemble NS, tous les enregistrements ont forcément le même TTL.
L'article seul
RFC 10033: Hash-based Signatures: State and Backup Management
Date de publication du RFC : Septembre 2026
Auteur(s) du RFC : T. Wiggers (PQShield), K. Bashiri
(BSI), S. Kölbl (Google), J. Goodman
(Crypto4A Technologies), S. Kousidis
(BSI)
Pour information
Réalisé dans le cadre du groupe de travail IETF pquip
Première rédaction de cet article le 15 septembre 2026
Certains algorithmes de cryptographie sont à état, c'est-à-dire que les programmes qui les utilisent doivent se souvenir des exécutions précédentes de l'algorithme ; refaire tourner l'algorithme dans les mêmes conditions serait une faille de sécurité. Cette nécessité de mémoriser un état complique évidemment leur utilisation. Ce nouveau RFC documente les bonnes pratiques à ce sujet.
La question des algorithmes à état est particulièrement cruciale dans le contexte de la cryptographie post-quantique. Un problème de beaucoup d'algorithmes post-quantiques est la grande taille de leurs clés et de leurs signatures, ce qui pose problème pour certaines applications sur l'Internet. Une solution possible serait d'utiliser des algorithmes comme ceux fondés sur la condensation, qui ont des clés et des signatures de taille plus raisonnable, et reposant sur ces algorithmes de condensation, qui sont bien connus. Mais ces algorithmes sont à état, ce qui est vraiment pénible à gérer.
Il existe plusieurs algorithmes dans cette famille fondée sur la condensation : LMS (Leighton–Micali Signatures), HSS (Hierarchical Signature System), XMSS (eXtended Merkle Signature Scheme), etc. Tous résistent aux futurs calculateurs quantiques mais tous ont un défaut : signer deux fois avec la même clé permet à la cryptanalyse de découvrir la clé privée. Il faut donc dériver une nouvelle clé à chaque signature et se souvenir des clés précédentes, pour ne pas risquer de réutilisation. C'est évidemment très contraignant et cela explique pourquoi, par exemple, ces algorithmes n'ont pas été sérieusement envisagés pour DNSSEC.
Si vous voulez vous instruire sur ces algorithmes utilisant la condensation, lisez les RFC 8391 (sur XMSS), RFC 8554 (sur LMS) et la norme NIST SP 800-208. Dans ces algorithmes, la clé privée est en fait une série de clés, partant d'une graine et créées par dérivations successives. L'état est simplement un index vers cette liste, indiquant la dernière clé utilisée. Si on réutilise une clé, on dévoile la graine. Il est donc très important de garder trace de l'index, de l'état. À chaque signature effectuée, il faut le mettre à jour. Imaginez par exemple un dispositif de signature qui signerait, diffuserait le message signé mais subirait ensuite une coupure de courant qui l'empêcherait de mettre à jour l'état. Une fois le courant revenu, la signature suivante utilisera le même index, donc la même clé et paf, le ou la cryptanalyste qui lira les deux signatures et connait la clé publique pourra trouver la graine, donc la clé privée. (Si ça vous semble magique, lisez « State Management for Hash- Based Signatures », « State management for stateful authentication mechanisms », « Oops, I did it again – Security of One-Time Signatures under Two-Message Attacks » et « Oops, I did it again revisited: another look at reusing one-time signatures ».) Notre RFC est donc consacré à décrire les mesures qui peuvent empêcher cette situation. Il faut s'assurer que l'état est bien mis à jour à chaque signature, que, dans le cas où il y a plusieurs signeurs, ils ne puissent jamais utiliser la même clé et que si on restaure les sauvegardes, on ne se trouve pas à réutiliser une clé. C'est compliqué ? Oui, et c'est pour cela que les algorithmes à état sont peu populaires. (Ils avaient été envisagés pour DNSSEC mais avaient fait peur à tout le monde.) Comme le note la section 1.1 du RFC, ces algorithmes ne conviennent pas pour un usage généraliste, il faut les réserver à des cas bien précis.
On peut même se demander pourquoi ces algorithmes n'ont pas été jetés à la poubelle tout de suite. C'est parce qu'ils ont quand même certains avantages, comme des tailles de clés et de signatures raisonnables. (DNSSEC, cité plus haut, ne peut pas envisager les énormes clés et signatures de ML-DSA.) Un exemple d'utilisation des systèmes à état est donné dans le RFC 9802.
La section 2 du RFC rappelle la terminologie utilisée. La clé privée à proprement parler est la graine dont dérivent les clés de signature. Elle-même est sans état et a potentiellement une longue durée de vie. Elle se gère comme n'importe quelle clé privée (donc, vous ne la mettez pas sur GitHub). L'état est au contraire à courte durée de vie et est mis à jour à chaque signature. Sa gestion (le mettre à jour, le sauvegarder, le distribuer…) est toute la difficulté des algorithmes de cryptographie à état.
Place à la pratique en section 3. Par exemple, les sauvegardes. Sauvegarder une clé qui peut servir pendant 10 ou 20 ans est une chose. Mais, ici, il faut sauvegarder du matériel cryptographique qui change tout le temps, puisque sauvegarder l'état est indispensable. La section 3.2 est une bonne lecture si vous vous intéressez aux questions de préservation de contenu numérique.
Mais il y a aussi le problème des procédures à suivre. Gérer des clés avec état est plus complexe et nécessite du personnel qualifié et consciencieux. Cela a des conséquences lorsqu'on calcule le coût total d'une solution cryptographique. D'autant plus que la sécurité peut nécessiter davantage de personnel, par exemple lorsqu'on déploie une solution M-sur-N pour contrer le risque d'une attaque menée de l'intérieur.
La section 4 liste les conséquences de ces exigences sous forme d'exigences ACID : la solution déployée doit permettre des transactions tout-ou-rien : l'utilisation de la signature et la mise à jour de l'état doivent être dans la même transaction (atomicité).
Suivre ces exigences en logiciel va être difficile : il peut y avoir une mémorisation de certaines informations, ce qui signifie que la version stockée sur un support stable n'a pas été mise à jour, il peut y avoir copie d'une machine virtuelle vers une autre, l'état étant alors dupliqué, etc. Le RFC conseille de plutôt utiliser un composant matériel dédié pour cette tâche délicate de maintien de l'état. Mais si vous voulez vraiment étudier la question en détail, et notamment les différents moyens d'atteindre nos objectifs, la section 5 discute de nombreuses solutions possibles.
Le RFC note aussi que ces exigences ne s'appliquent qu'au signeur. Le vérificateur des signatures, lui, peut complètement ignorer le problème et ne pas connaitre l'état.
L'article seul
RFC 10032: The AEGIS Family of Authenticated Encryption Algorithms
Date de publication du RFC : Septembre 2026
Auteur(s) du RFC : F. Denis (Fastly), S. Lucas
Pour information
Réalisé dans le cadre du groupe de recherche IRTF cfrg
Première rédaction de cet article le 19 septembre 2026
L'imagination des cryptologues est sans fin, voici une nouvelle famille d'algorithmes de chiffrement, fondés sur le classique AES, la famille AEGIS (qui, au moment d'écrire cet article, n'a pas encore de page Wikipédia). AEGIS permet de réutiliser le jeu d'instructions AES mais est plus rapide qu'AES et fournit du chiffrement intègre.
AEGIS est issu du concours CAESAR. Il existe en plusieurs versions, AEGIS-128, AEGIS-128L, AEGIS-128X, AEGIS-256 et AEGIS-256X (ils sont désormais dans le registre IANA des algorithmes de chiffrement intègre). Comme leurs noms l'indiquent, ces algorithmes diffèrent par la taille des clés utilisées mais tous utilisent les fonctions de base d'AES (norme NIST.FIPS.197-upd1), ce qui leur permet d'utiliser les mises en œuvre matérielles d'AES. AEGIS peut être vu comme de l'AES plus rapide.
En outre, AEGIS est normalement plus sûr qu'AES en mode GCM (les autres modes d'AES n'offrent pas de chiffrement intègre et ne sont donc pas vraiment comparables). Avec AES-GCM, on peut trouver des textes chiffrés qui se déchiffrent correctement avec plusieurs clés, ce qui facilite certaines attaques (cf. « Partitioning Oracle Attacks). Ce n'est pas possible avec AEGIS. D'autre part, la clé utilisée ne sert qu'au tout début, le chiffrement ou déchiffrement sera fait après une dérivation, on pourra donc effacer la clé de la mémoire rapidement, diminuant les risques qu'un méchant ne la copie.
Si vous voulez en savoir plus, ne comptez pas sur mes faibles connaissances en cryptographie, lisez les sections 2 à 8 du RFC, qui expliquent les algorithmes de la famille AEGIS, avec pseudo-code. Puis, pour approfondir, « Analyzing the Linear Keystream Biases in AEGIS », « Guess-and-Determine Attacks on AEGIS », « Weak Keys in Reduced AEGIS and Tiaoxin » ou « MILP-based security evaluation for AEGIS/Tiaoxin-346/ Rocca ».
AEGIS est aujourd'hui mis en œuvre dans plusieurs bibliothèques logicielles, dans de très nombreux langages de programmation. Si vous voulez contribuer à ces codes, ou bien en créer un nouveau, n'oubliez pas de tester avec les vecteurs de test de l'annexe A (également disponibles en ligne).
Les fans de cryptologie liront avec plaisir la section 9 qui analyse les problèmes de sécurité potentiels d'AEGIS. J'ai noté que cette section estime qu'AEGIS est résistant aux calculateurs quantiques, en tout cas s'il n'y a pas de lien quantique avec le système qui fait tourner AEGIS (ce qu'on appelle traditionnellement le « modèle Q1 d'attaquant », le modèle Q2 étant un attaquant complètement quantique).
L'article seul
RFC 10024: Post-Quantum Traditional (PQ/T) Hybrid Key Agreement Mechanisms for TLS 1.3
Date de publication du RFC : Août 2026
Auteur(s) du RFC : K. Kwiatkowski (PQShield), P. Kampanakis (AWS), B. E. Westerbaan (Cloudflare), D. Stebila (University of Waterloo)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF tls
Première rédaction de cet article le 20 août 2026
On met du post-quantique partout en ce moment. Ce court RFC normalise l'utilisation de clés hybrides (post-quantiques et traditionnelles) dans les échanges de clés de TLS.
Les trois mécanismes normalisés dans ce RFC utilisent tous ML-KEM, qui est normalisé dans FIPS-203. ML-KEM repose sur les réseaux euclidiens et les experts en cryptographie ne sont pas sûrs à 100 % de sa sécurité. Dans le doute, il est donc recommandé de l'utiliser combiné avec un algorithme traditionnel, comme décrit dans le RFC 9954. Ainsi, on est protégé à la fois contre les futurs CRQC (Cryptographically-Relevant Quantum Computer) et contre la cryptanalyse plus classique. Les principes de cette méthode hybride sont décrits en détail dans le RFC 9794 et le RFC 9954 déjà cité.
Les trois mécanismes d'échange de clés pour TLS normalisés ici (et qui sont appelés « groupes » pour des raisons historiques) sont :
- X25519MLKEM768, qui combine l'algorithme traditionnel à courbes elliptiques X25519 (RFC 7748) avec ML-KEM, et qui est le mécanisme recommandé.
- SecP256r1MLKEM768, qui combine SecP256 (norme FIPS-186, donc une courbe elliptique différente, la P256) avec ML-KEM, et qui a l'avantage ou l'inconvénient de n'utiliser que des algorithmes NIST.
- SecP384MLKEM1024, proche du précédent mais avec des clés plus longues et une courbe elliptique différente, avec normalement davantage de sécurité.
Pour les trois mécanismes traditionnels, avec des courbes elliptiques, l'algorithme ECDH est utilisé.
Pour réaliser l'échange de clés au début d'une session TLS, on fait tourner le mécanisme traditionnel et le post-quantique, et on concatène les deux clés. (Oui, je simplifie, que les experts en cryptographie m'excusent, la sortie d'ECDH utilisée n'est pas vraiment la clé.) On notera que, pour X25519MLKEM768, la clé faite via ML-KEM fait 1 184 octets et celle d'ECDH seulement 32 octets ; c'est un problème avec beaucoup d'algorithmes post-quantiques, dont les clés et les signatures sont très longues. (Et, oui, on n'utilise pas directement ces « clés » mais un dérivé.)
Si on se soucie de conformité plutôt que de sécurité, on lira avec bonheur la section 5 du RFC, qui décrit en détail la conformité de ce RFC avec les règles FIPS (c'est surtout utile si vous travaillez pour le gouvernement étatsunien).
Et si vous vous intéressez aux débats sur la sécurité de ML-KEM et sur le concept même d'hybride, parmi les nombreux articles publiés, je vous recommande celui de Sophie Schmieg.
Les trois mécanismes d'échange de clés ont été ajoutés au registre IANA, avec respectivement les numéros 4588, 4587 et 4589.
Voici, vus par Firefox (« Outils de développement Web » puis « Réseau » puis « Sécurité », tout au bout), les algorithmes cryptographiques utilisés avec un serveur HTTPS qui accepte un des mécanismes de notre RFC. Il y a en tout trois éléments à la liste car il faut trois choses pour faire du TLS :
- Un algorithme d'échange de clés (c'est le sujet de ce RFC), ici mlkem768x25519 (X25519MLKEM768 dans le RFC, c'est aussi ce qu'afficherait Chrome),
- Un algorithme d'authentification via une signature, ici RSA-PSS-SHA256 (c'est l'algorithme que vous trouverez dans le certificat),
- Un algorithme pour le chiffrement symétrique, une fois que les clés de session auront été échangées, ici ChaCha20 avec Poly1305.
Seul le premier des trois cités inclut du post-quantique. RSA
pourrait faire l'échange de clés (une des parties génère une clé de
session et la chiffre avec RSA avant de l'envoyer) et la signature
mais ML-KEM ne sait faire que l'échange de clés.

À part Firefox, Chrome gère ces nouveaux
mécanismes (qui sont déjà dans plusieurs
bibliothèques de cryptographie, cf. par
exemple la
liste de Cloudflare), ainsi que des hébergeurs comme
Cloudflare ou
AWS. Voici une connexion vue par Chrome :

Jouons un peu avec OpenSSL maintenant. On va utiliser la version qui est dans Debian stable. D'abord, créons un certificat pour ECDSA :
% openssl version
OpenSSL 3.5.4 30 Sep 2025 (Library: OpenSSL 3.5.4 30 Sep 2025)

% openssl ecparam -out server.pem -name prime256v1 -genkey

% openssl req -new -key server.pem  -nodes -out server.csr
…
Country Name (2 letter code) [AU]:FR
…

% openssl x509 -in server.csr -out server.crt -req -signkey server.pem -days 2001
Certificate request self-signature ok
subject=C=FR…
Maintenant qu'on a le certificat, lançons le serveur en lui disant qu'on accepte d'échanger les clés en X25519MLKEM768 (et qu'on écoute sur le port 12345) :
% openssl s_server -tls1_3 -groups X25519MLKEM768 -accept 12345 -cert server.crt -key server.pem
Firefox va pouvoir s'y connecter et affichera :
Version du protocole :	"TLSv1.3"
Suite de chiffrement :	"TLS_AES_128_GCM_SHA256"
Groupe d’échange de clés :	"mlkem768x25519"
Algorithme de signature :	"ECDSA-P256-SHA256"
Le serveur OpenSSL annonce quant à lui :
Shared ciphers:TLS_AES_128-GCM-SHA256:ECDHE-ECDSA-CHACHA20-POLY1305:ECDHE-RSA-CHACHA20-POLY1305:ECDHE-ECDSA-AES256-GCM-SHA384:ECDHE-RSA-AES256-GCM-SHA384:ECDHE-ECDSA-AES256-SHA:ECDHE-ECDSA-AES128-SHA:ECDHE-RSA-AES128-SHA:ECDHE-RSA-AES256-SHA:AES128-GCM-SHA256:AES256-GCM-SHA384:AES128-SHA:AES256-SHA
Signature Algorithms: ECDSA+SHA256:ECDSA+SHA384:ECDSA+SHA512:RSA-PSS+SHA256:RSA-PSS+SHA384:RSA-PSS+SHA512:RSA+SHA256:RSA+SHA384:RSA+SHA512:ECDSA+SHA1:RSA+SHA1
Shared Signature Algorithms: ECDSA+SHA256:ECDSA+SHA384:ECDSA+SHA512:RSA-PSS+SHA256:RSA-PSS+SHA384:RSA-PSS+SHA512:RSA+SHA256:RSA+SHA384:RSA+SHA512
Supported groups: X25519MLKEM768:x25519:secp256r1:secp384r1:secp521r1:ffdhe2048:ffdhe3072
Shared groups: X25519MLKEM768
CIPHER is TLS_AES_128_GCM_SHA256
À noter que si on avait lancé le serveur avec -groups
MLKEM768, Firefox ne pouvait se connecter (no
suitable key share) puisqu'il ne gère pas ML-KEM seul,
uniquement dans un contexte hybride (ML-KEM et ECDH-X25519). L'usage
de ML-KEM seul est décrit dans l'Internet
draft draft-ietf-tls-mlkem. Et
si vous voulez connaitre tous les mécanismes d'échange de clés de
votre installation d'OpenSSL :
% openssl list -kem-algorithms
  { 1.2.840.113549.1.1.1, 2.5.8.1.1, RSA, rsaEncryption } @ default
  { 1.2.840.10045.2.1, EC, id-ecPublicKey } @ default
  { 1.3.101.110, X25519 } @ default
  { 1.3.101.111, X448 } @ default
  { 2.16.840.1.101.3.4.4.1, id-alg-ml-kem-512, ML-KEM-512, MLKEM512 } @ default
  { 2.16.840.1.101.3.4.4.2, id-alg-ml-kem-768, ML-KEM-768, MLKEM768 } @ default
  { 2.16.840.1.101.3.4.4.3, id-alg-ml-kem-1024, ML-KEM-1024, MLKEM1024 } @ default
  X25519MLKEM768 @ default
  X448MLKEM1024 @ default
  SecP256r1MLKEM768 @ default
  SecP384r1MLKEM1024 @ default
(Pour ceux de signature, c'est openssl list
-signature-algorithms et, logiquement, on n'y trouve pas ML-KEM.)
Et dans curl ? Je n'ai pas testé mais normalement ceci marche :
curl -v --curves X25519MLKEM768 https://example.com
L'article seul
RFC 10023: The "_for-sale" Underscored and Globally Scoped DNS Node Name
Date de publication du RFC : Juillet 2026
Auteur(s) du RFC : M. Davids (SIDN Labs)
Pour information
Première rédaction de cet article le 31 juillet 2026
Vous vendez un ou plusieurs noms
de domaine ? Alors, marquez-les comme étant en vente, en
ajoutant le sous-domaine _for-sale, dont le
contenu permettra de donner des informations à d'éventuels
clients.
C'est une simple convention, qui ne modifie en rien le DNS et ne nécessite pas de changer les logiciels. Voici un exemple, avec un domaine de test :
% dig +short +nodnssec  _for-sale.example.nl. TXT
"v=FORSALE1;furi=https://example.nl/for-sale.txt"
"v=FORSALE1;ftxt=See the URL for important information!"
…
Il existe en effet toute une activité d'achat et de vente de noms de domaine. On la nomme en anglais domaining et ses pratiquants sont les domainers (parfois francisés en domaineurs). Quels que soient les sentiments que peuvent inspirer les pratiques, pas toujours très belles, de ces domaineurs, il faut noter qu'il s'agit d'une activité légale, explicitement prévue par de nombreux registres. Comment travaillent ces domaineurs ? Ils cherchent des noms « intéressants », regardent s'ils sont libres et les enregistrent, dans l'espoir de les revendre plus cher. Ou bien, s'ils ne sont pas libres, essaient parfois des les racheter à leurs titulaires, toujours dans l'espoir d'un bénéfice.
Comment savoir si un domaine est libre ? (Non, pas en faisant une
requête DNS ; un
nom peut être enregistré mais pas
publié dans le DNS.) Il existe des solutions normalisées
comme whois (RFC 3912)
ou RDAP (RFC 9083). Même si
le nom n'est pas libre, on
peut tenter de le racheter. Il existe des plate-formes de mise en contact de
vendeurs et d'acheteurs, comme par exemple
Sedo : 
(Sedo est juste un exemple ; il y en a d'autres, parfois gérés par des BE. Par exemple Afternic est propriété de GoDaddy. On trouve aussi des noms de domaine sur des plate-formes plus classiques par exemple en France Boischaut en vend sur InterEnchères. Attention, ces noms de plate-formes ne sont donnés qu'à titre d'exemple et ne sont certainement pas une recommandation. Une liste à jour de ces plate-formes est disponible.)
Mais il est préférable de pouvoir se passer
d'intermédiaire. Notre nouveau RFC propose donc une solution sans
intermédiaire pour prévenir que le nom de domaine est en vente :
vous ajoutez un sous-domaine _for-sale à votre
domaine, qui indique explicitement que vous vendez ce nom. Pourquoi
le précéder d'un tiret bas ? Pour limiter les
risques de collision avec les autres noms enregistrés (RFC 8552). Quelles valeurs associer à ce nom ? Un
enregistrement de type TXT, qui va donner des détails sur ce que le
vendeur propose. Plus précisément (section 2 du RFC), vous devez
commencer chaque enregistrement par
v=FORSALE1;. Vous pouvez ensuite ajouter au
choix (un seul par enregistrement mais vous pouvez mettre plusieurs
enregistrements) des couples clé=valeur :
- Une référence pour vous, avec la clé
fcod, qui peut permettre d'indiquer un identificateur sur une plate-forme d'achat et vente. - Un texte libre, avec
ftxt. Il est fortement recommandé qu'il soit en UTF-8 (RFC 3629), même si la norme DNS ne l'impose pas. En prime, le RFC recommande d'utiliser le profil limité du RFC 5198 et celui du RFC 9839, section 4.3. - Un URI, pour aller chercher davantage
d'informations (clé
furi). Le RFC recommande de se limiter aux planshttp,https,mailtoettel. Et de ne pas suivre automatiquement ces liens, ils peuvent être malveillants (section 4). Demandez confirmation plutôt deux fois qu'une. - Le prix demandé, avec la clé
fval. La monnaie utilisée doit être indiquée en suivant la norme ISO 4217.
Les enregistrements TXT associés au nom
_for-sale qui ne commenceraient pas par
v=FORSALE1; peuvent être ignorés (mais ils
peuvent contenir des informations supplémentaires). Si aucun
enregistrement TXT de ce sous-domaine ne commence par
v=FORSALE1;, il faut ignorer ce nom, et ne pas
considérer que le domaine est réellement en vente (cela peut être
l'effet d'un joker DNS, regardez par exemple
unipol-tech.com, il n'est pas en vente mais il y a un
joker, vous verrez un TXT pour n'importe quel nom comme
_for-sale.unipol-tech.com, cf. section 3.1).
Vous avez des exemples dans le RFC, section 2 et annexe A mais, sinon,
regardons le domaine cours-dns.fr. Vous pouvez regarder
avec dig :
%  dig _for-sale.cours-dns.fr TXT


; <<>> DiG 9.18.39-0ubuntu0.24.04.2-Ubuntu <<>> _for-sale.cours-dns.fr TXT
;; global options: +cmd
;; Got answer:
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 50746
;; flags: qr rd ra ad; QUERY: 1, ANSWER: 6, AUTHORITY: 0, ADDITIONAL: 1

;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags: do; udp: 1232
;; QUESTION SECTION:
;_for-sale.cours-dns.fr.	IN TXT

;; ANSWER SECTION:
_for-sale.cours-dns.fr.	300 IN TXT "Read RFC 10023 to learn more"
_for-sale.cours-dns.fr.	300 IN TXT "v=FORSALE1;furi=https://www.afnic.fr/en/products-and-services/training/"
_for-sale.cours-dns.fr.	300 IN TXT "v=FORSALE1;fcod=42"
_for-sale.cours-dns.fr.	300 IN TXT "v=FORSALE1;fval=BTC1000"
_for-sale.cours-dns.fr.	300 IN TXT "v=FORSALE1;ftxt=Make money fast / Soyez friqu\195\169 rapidement"
_for-sale.cours-dns.fr.	300 IN RRSIG TXT 15 3 300 (
				20260303165737 20260216165737 37133 cours-dns.fr.
				pxYB9Wxx95+vSgzM1A+HfKyelYeHaHnbq/OIiK5IDW4L
				oC9ir7wG4pb4ehjHg8mrBEHguxiyT9UIL7ROSU/BAQ== )

;; Query time: 10 msec
;; SERVER: 192.168.2.254#53(192.168.2.254) (UDP)
;; WHEN: Thu Feb 19 10:50:27 CET 2026
;; MSG SIZE  rcvd: 454
(Notez que dig n'affiche pas le texte UTF-8 correctement.) Ou bien, plus joli, avec le DNS Looking Glass (là, l'Unicode est bien affiché). Ou bien via le démonstrateur de SIDN Labs, qui permet d'afficher plus proprement (en néerlandais) ces informations.
Bon, si vous voulez la même chose avec un vrai domaine vraiment en vente :
% dig _for-sale.actuals.nl TXT

; <<>> DiG 9.20.18-1~deb13u1-Debian <<>> _for-sale.actuals.nl TXT
;; global options: +cmd
;; Got answer:
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 61541
;; flags: qr rd ra; QUERY: 1, ANSWER: 2, AUTHORITY: 0, ADDITIONAL: 1

;; OPT PSEUDOSECTION:
; EDNS: version: 0, flags: do; udp: 1232
;; QUESTION SECTION:
;_for-sale.actuals.nl.	IN TXT

;; ANSWER SECTION:
_for-sale.actuals.nl.	1800 IN	TXT "v=FORSALE1;fcod=NLFS-OTQ0NTY5Y2YtY2ExNS00YWM0LTljNTgtN2I2YmU3Mzc4Njg5"
_for-sale.actuals.nl.	1800 IN	TXT "v=FORSALE1;furi=https://api.nameshift.com/sidn?domain=actuals.nl"

;; Query time: 32 msec
;; SERVER: ::1#53(::1) (UDP)
;; WHEN: Thu Feb 19 10:57:33 CET 2026
;; MSG SIZE  rcvd: 208
Vous noterez que le fcod est reconnu par la
plate-forme du .nl et
l'URI donné vous y emmène directement. 
Question sémantique, le RFC note que le
_for-sale n'est pas une promesse : le titulaire
du domaine qui met ce sous-domaine ne s'engage pas à vendre, il a
parfaitement le droit de renoncer à l'opération. C'est d'autant plus
vrai que le _for-sale récupéré peut avoir été
supprimé mais que votre résolveur DNS
l'avait gardé en mémoire (la section 3.4 met en garde contre les
TTL trop longs, la FAQ suggère une
heure).
Autre point amusant : un sous-domaine
_for-sale peut apparaitre partout dans l'arbre
des noms de domaines, donc on pourrait voir
Verisign publier un
_for-sale.com si cette entreprise voulait
vendre .com 😃. Seul
.arpa est exclu par le RFC. (Et la racine ? Le
RFC n'en parle pas.)
La section 4, sur la sécurité, rappelle qu'il faut considérer que le contenu de ces enregistrements TXT n'est pas sûr : il peut y avoir du XSS ou des tentatives d'injection SQL par exemple. Si vous écrivez un programme qui analyse ces enregistrements, soyez très paranoïaque.
Il y a aussi un risque non technique, celui de malhonnêtes
publiant des enregistrements _for-sale
alléchants mais trompeurs (_for-sale.sex.com. TXT
"V=FORSALE1; ftxt=Make money fast!!! Only $100!") afin de
vous amener à visiter un site Web de publicité ou de
hameçonnage. Il ne faut surtout pas, par exemple, lancer
automatiquement un achat sur la base de ces enregistrements.
Et puis rappelez-vous que les informations dans le DNS sont publiques, et que n'importe qui peut donc savoir que vous voulez vendre (c'est bien le but, mais il faut se souvenir que tout le monde, pas juste les acheteurs potentiels sérieux, verra ces informations, et elles peuvent contenir des données que vous ne voudriez pas trop diffuser comme les noms et adresses des personnes à contacter).
Le principal registre
promoteur de cette technique est celui du
.nl. Son interface Web
permet de voir, lorsqu'on affiche des informations sur un domaine,
qu'il est en vente (regardez par exemple https://www.sidn.nl/en/whois?q=123huren.nl

Il y a une page
officielle du projet avec beaucoup d'information, d'outils et
de détails. (Voir aussi ce site.) Le code
source est disponible. Il y a même un
MCP ! (Je ne l'ai pas
testé.) Pour créer vos enregistrements, vous pouvez vous aider de
ce générateur. Il existe aussi un
vérificateur d'enregistrements (notez qu'il a été écrit en
partie par un LLM à qui on a fait lire le brouillon du
RFC). La zone testdns.nl a une incroyable
collection d'enregistrements _for-sale, pour
tester les outils. Et évidemment, vous avez un assistant IA.
Le composant _for-sale a été ajouté au registre
IANA des noms préfixés d'un trait bas, registre qui avait été
défini par le RFC 8552.
L'article seul
RFC 10008: The HTTP QUERY Method
Date de publication du RFC : Juin 2026
Auteur(s) du RFC : J. Reschke (greenbytes), J.M. Snell
(Cloudflare), M. Bishop (Akamai)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF httpbis
Première rédaction de cet article le 16 juin 2026
Ce n'est pas tous les jours qu'on normalise une nouvelle méthode HTTP. Bienvenue, donc, à QUERY, qui rejoint des méthodes bien plus anciennes comme GET et POST. QUERY peut être décrit comme « GET mais avec un corps dans la requête ». Comme GET, elle est idempotente et donc sûre à répéter.
L'idée est de pouvoir interroger, par exemple, un service de recherche (vous verrez un exemple plus loin sur mon blog). Sans QUERY, on envoyait quelque chose du genre :
GET /feed?q=foo&limit=10&sort=published HTTP/1.1
On est donc obligés de mettre les paramètres dans l'URL. Cela peut poser problème si les paramètres sont nombreux et de grande taille, cela oblige à les pourcent-encoder et cela peut poser des problèmes de vie privée (l'URL demandé a des chances d'être enregistré dans un journal).
Des gens utilisent donc POST pour une recherche, bien qu'il n'ait pas la bonne sémantique :
POST /feed HTTP/1.1

q=foo&limit=10&sort=published
Mais on ne voit plus que la requête est idempotente. Un navigateur Web n'osera pas la répéter ou bien demandera confirmation à l'utilisateur. Et on ne pourra pas facilement mémoriser le résultat (puisque le client ne sait pas si la requête n'a pas d'effets de bord). QUERY résout le problème :
QUERY /feed HTTP/1.1

q=foo&limit=10&sort=published
La méthode est idempotente, le résultat peut être mémorisé.
La section 2 du RFC décrit avec précision QUERY. À lire si vous écrivez des clients ou des serveurs qui l'utilisent. Par exemple, puisque QUERY, contrairement à GET, inclut un corps dans la requête, le client doit indiquer le type de média utilisé, et sans se tromper, sinon le serveur lui renverra un 400. (Et un 415 si le type est bien là mais que le serveur ne le connait pas.) Autre chose à noter : en cas de redirection, le client ne doit pas changer de méthode (alors qu'on pouvait changer un POST en GET si la redirection était faite avec 301 ou 302). Autrement, QUERY ressemble beaucoup dans son comportement à GET. QUERY est désormais enregistré dans le registre des méthodes HTTP.
Un serveur HTTP qui met en œuvre QUERY n'accepte pas forcément
n'importe quel format en entrée. Pour documenter ce qu'il accepte
comme corps de la requête, notre RFC introduit un nouveau
champ HTTP, Accept-Query: (section 3)
qui est la liste des types de média
acceptés.
Vous avez plein d'exemples de requêtes et de réponses dans l'annexe A.
Il y a une mise en œuvre de QUERY sur ce blog, pour fournir un
moteur de recherche des
articles. L'URL est
https://www.bortzmeyer.org/methodquery et voici
un exemple d'utilisation avec curl :
% curl --request QUERY --data query=framasoft https://www.bortzmeyer.org/methodquery

    Query of "framasoft" OK

    https://www.bortzmeyer.org/capitole-du-libre-2023.html "Capitole du Libre 2023, et mon exposé sur la censure de l'Internet"
    …
Vous pouvez avoir une documentation plus détaillée de ce service
au début de son code source (en Python),
method-query.pytest-http-query.py
En parlant de curl, notez que, lorsqu'il suit
une redirection HTTP (option --location), il ne
transmet pas actuellement le
corps de la requête, ce qui casse ce service. Il faut de toute façon
utiliser
--follow.
La création de cette nouvelle méthode (ce qui est rare, je crois que la précédente avait été PATCH dans le RFC 5789 il y a quinze ans) a pris du temps. Le premier projet avait été rédigé en 2015 et le travail a connu plusieurs interruptions. Une des discussions avait porté sur le nom de la méthode, qui aurait pu s'appeler SEARCH (réutilisant une méthode normalisée dans le RFC 5323). L'annexe B du RFC discute le choix qui a été fait.
Une autre discussion portait sur le code de retour HTTP, un problème classique de tous les services tournant sur HTTP : si la requête est bien transmise et traitée mais qu'on n'a pas de résultat, doit-on quand même renvoyer le 200, qui signifie que tout s'est bien passé ? Avec GET, on utilise souvent 404 dans ce cas, mais c'est parce que le terme de recherche est dans l'URL, ce qui n'est plus le cas ici. On aurait pu aussi avoir un nouveau code commençant par 2. Finalement, le choix a été de renvoyer 200 quand la requête est bien arrivée et que le moteur de recherche a fonctionné, même s'il n'a rien trouvé. (Une discussion analogue avait eu lieu pendant le développement de DoH. Le RFC 8484 avait finalement décidé de répondre 200 même si le nom de domaine demandé n'existait pas.)
Ah, et si vous voulez superviser votre service HTTP utilisant QUERY, le programme check_http des monitoring plugins le permet. Voici un exemple de configuration pour Icinga :
vars.http_vhosts["query"] = {
    http_uri = "/methodquery"
    http_vhost = "www.bortzmeyer.org"
    http_ssl = true
    http_sni = true
    http_method = "QUERY"
    # Notez que le nom de la variable n'est pas très heureux.
    http_post = "query=foobar"
    http_content_type = "application/x-www-form-urlencoded"
    http_string = "foobar\" OK"
    http_timeout = 15
}
Sinon, si vous voulez d'autres lectures, il y a un bon article de Tykok.
L'article seul
RFC 10001: Operational Guidelines for DNS Transport in Mixed IPv4/IPv6 Environments
Date de publication du RFC : Août 2026
Auteur(s) du RFC : Momoka (WIDE Project), T. Fiebig (MPI-INF)
Réalisé dans le cadre du groupe de travail IETF dnsop
Première rédaction de cet article le 31 août 2026
Vous gérez des serveurs DNS (qu'ils soient des résolveurs ou des serveurs faisant autorité) dans un environnement où il y a à la fois IPv4 et IPv6 ? Alors, ce RFC va vous aider. Il remplace le RFC 3901, qui avait été écrit pour un monde très différent, où IPv6 était marginal. Désormais, la recommandation est que tout serveur DNS doit pouvoir servir les requêtes avec les deux versions d'IP.
Alors que le plan de transition initial pariait sur une migration de quelques années suite à laquelle IPv4 ne serait plus qu'un souvenir, la réalité est celle d'une co-existence de longue durée des deux versions (cf. RFC 9386). Le retard avec lequel certains acteurs de l'Internet ont migré fait que le paysage d'aujourd'hui est très complexe, avec des réseaux purement IPv4, des réseaux purement IPv6 et des réseaux mixtes. Si une zone DNS n'est servie que par des serveurs en IPv6, un résolveur n'ayant qu'IPv4 ne pourra pas la résoudre, et c'est pareil en sens inverse. On aurait une fragmentation de l'espace des noms de domaine, et c'est ce qu'il faut éviter. (Du fait du caractère arborescent du DNS, la fragmentation pourrait aussi se produire si un domaine parent, quelque part entre la racine et le domaine que vous voulez résoudre, n'avait qu'IPv4 ou qu'IPv6. Le RFC cite un cas encore plus amusant où, dans la chaine des noms, certains domaines ne sont accessibles qu'en IPv4 et d'autres qu'en IPv6 ; seul un résolveur à double pile - IPv4 et IPv6 - pourrait résoudre les noms situés au bout de cette chaine.) La lecture de « How Ready is DNS for an IPv6-Only World? » est recommandée.
Lorsque le RFC 3901, premier RFC à parler de la version d'IP utilisée pour transporter les requêtes et les réponses DNS, a été écrit, le paysage était nettement dominé par IPv4. Ce RFC 3901 se préoccupait surtout de maintenir la résolution de noms avec les zones existantes, dont l'écrasante majorité n'était servie qu'en IPv4. Aujourd'hui (voyez le rapport ARCEP), IPv6 est dans une position très différente, dans certains pays, la grande majorité des réseaux d'accès fournit IPv6, et les gros services Web populaires ont souvent IPv6. Bien des réseaux sont purement IPv6 à la base, IPv4 étant désormais un service fourni au-dessus d'IPv6. Le RFC 6540 considère à juste titre que IP, aujourd'hui, implique IPv6. Notre RFC remplace donc le RFC 3901 pour demander de l'IPv6 sur tous les serveurs faisant autorité et tous les résolveurs.
Un petit rappel au passage : ce RFC parle du transport des données dans les requêtes et les réponses DNS, pas des données elles-mêmes. Une requête/réponse pour des données de type A (adresses IPv4) peut se faire sur des messages échangés sur IPv6 et une requête/réponse pour des données de type AAAA (adresses IPv6) peut se faire sur des messages échangés sur IPv4.
Donc, il faut IPv4 et IPv6 sur les serveurs. Mais il ne suffit pas de croire qu'on a activé les deux. Des erreurs de configuration peuvent faire qu'on pense avoir IPv4 et IPv6 mais qu'un des deux ne marche pas. Cela peut être dû à un pare-feu qu'on a mis devant le serveur DNS (une mauvaise idée, en général, mais c'est une autre histoire) et qui n'autorise qu'une des deux versions. Mais il peut aussi y avoir des erreurs spécifiquement DNS :
- Les serveurs faisant autorité ont IPv4 mais pas d'enregistrements de type A (ou bien ils ont IPv6 mais on a oublié de publier un AAAA),
- les serveurs ont bien les enregistrements A et AAAA dans leur zone mais on a oublié la colle (RFC 9471),
- il y a la colle mais pas d'enregistrements dans la zone, ce
qui empêcherait les résolveurs qui revalident (cf.
draft-ietf-dnsop-ns-revalidation) de résoudre le nom, - le nom du serveur de noms est dans une autre zone, qui n'est pas elle-même résolvable en IPv4 et IPv6,
- une des zones situées au-dessus, dans l'arbre du DNS, n'est pas résolvable avec les deux versions d'IP (la résolution DNS part de la racine et suit un chemin descendant dans l'arbre des noms de domaine).
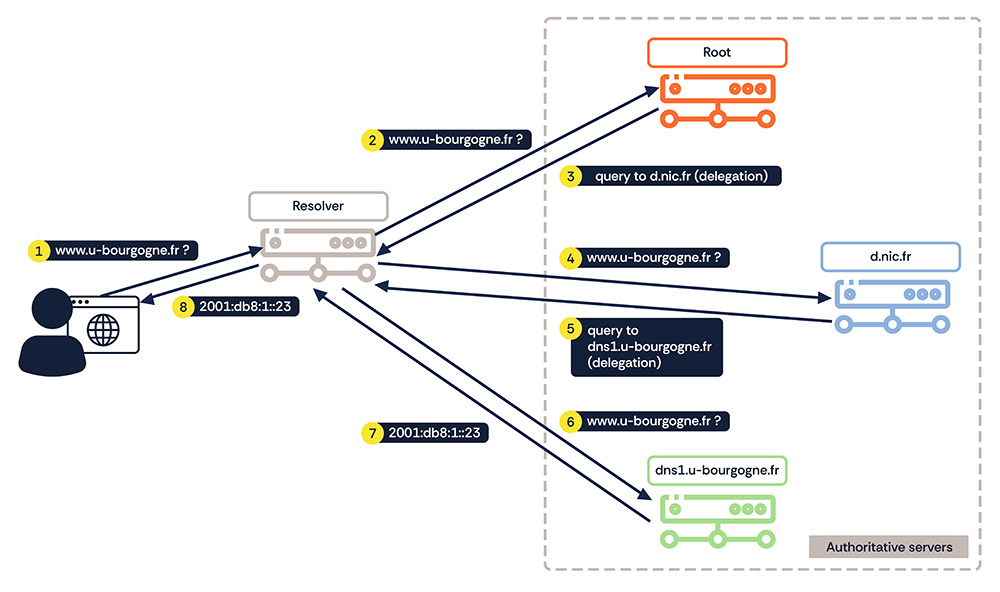
Toutes ces erreurs possibles imposent à l'administrateurice DNS de vérifier sa zone. On ne doit pas se contenter de se dire « c'est bon, j'ai tout configuré, on doit tester, par exemple avec Zonemaster (ou, en plus léger et moins riche, check-soa). Et re-tester régulièrement car des erreurs peuvent survenir par la suite.
% check-soa bortzmeyer.org
ns-global.kjsl.com.
	23.128.97.53: OK: 2026083000
	2607:7c80:53::53: OK: 2026083000
ns.eu.org.
	78.194.169.74: OK: 2026083000
ns1.bortzmeyer.org.
	80.77.95.49: OK: 2026083000
	2602:fbb1:1:245b::42: OK: 2026083000
ns1.shaftinc.fr.
	2001:41d0:404:200::49e1: OK: 2026083000
	51.178.53.118: OK: 2026083000
ns2.bortzmeyer.org.
	2400:8902::f03c:91ff:fe69:60d3: OK: 2026083000
	172.104.125.43: OK: 2026083000
ns2.shaftinc.fr.
	2a05:f480:1c00:28a:5400:2ff:fee7:316f: OK: 2026083000
	136.244.112.196: OK: 2026083000
ns4.bortzmeyer.org.
	2001:4b98:dc0:41:216:3eff:fe27:3d3f: OK: 2026083000
	92.243.4.211: OK: 2026083000
Il peut aussi y avoir des problèmes dûs au réseau. L'un des plus
courants est un problème de MTU. Si la réponse, notamment en raison des
signatures DNSSEC, dépasse la MTU du chemin, elle devra
être fragmentée et, dans l'Internet tel qu'il
est, cela se passera souvent mal (cf. RFC 8900
et RFC 9715). Il vaut mieux, pour un serveur
DNS, éviter d'envoyer des réponses trop grosses (le RFC suggère
1 232 octets maximum), pour être sûr qu'il n'y ait pas de
fragmentation. (Attention, le mot « fragmentation » ici n'a pas le
même sens que plus haut, quand on parlait de fragmentation de
l'espace de noms.) Notez que DNSSEC n'est pas nécessaire pour faire
des grosses réponses. Essayez oracle.com/TXT
pour voir.
Ça, c'était pour UDP. Et pour TCP ? Bien sûr, la découverte de la MTU du chemin existe (RFC 8201, RFC 8899) mais elle prend du temps alors que le DNS est censé avoir une très faible latence. Le RFC recommande donc de configurer la MSS à moins de 1 388 octets.
Mais il n'y a pas que la MTU. Par exemple, un résolveur peut avoir des problèmes de connectivité. Un cas où elle sera interrompue de manière intermittente (et donc difficile à déboguer) est celui où le résolveur est derrière un routeur CGNAT (RFC 6888) avec des délais d'expiration des « connexions » très court. Le trafic DNS, plutôt variable, ne sera pas suffisant pour maintenir la « connexion » ouverte. Et le RFC cite de nombreux autres exemples de problèmes réseau possibles.
Il est aussi possible qu'un serveur ne soit pas accessible avec une des deux versions d'IP suite à un choix délibéré. Si on regarde le domaine de la BNF, par exemple :
% check-soa bnf.fr
ariane.bnf.fr.
	193.50.133.237: OK: 2026081807
galatee.bnf.fr.
	193.50.133.202: OK: 2026081807
Pas d'IPv6 du tout. Comme le FAI de la BNF route l'IPv6, c'est certainement
un choix délibéré. En 2023 (étude « How
Ready is DNS for an IPv6-Only World? »), presque
aucun domaine n'avait que IPv6 alors que presque la moitié de ceux
testés n'avait que IPv4 (comme bnf.fr).
Après ces observations et analyses, le RFC, dans sa section 4, en arrive aux recommandations. Pour les serveurs faisant autorité, il faut, notamment :
- La règle « au moins deux serveurs faisant autorité par zone » devrait désormais être entendue comme « au moins deux en IPv4 et deux en IPv6 ». (On notera que cela ne figure pas dans les recommandations IANA, cf. section 6 du RFC.) Zonemaster fait déjà ce test (« Les serveurs de noms de la zone ne retournent pas assez de serveurs (1) faisant autorité ayant une adresse IPv6. La limite inférieure étant fixée à 2. »).
- Évidemment, ces (au moins) deux serveurs IPv6 ne doivent pas utiliser des adresses IPv6 spéciales, genre IPv4-embedded (RFC 6052), et la résolution de leurs noms ne doit pas nécessiter IPv4.
- Toujours aussi évidemment, les serveurs faisant autorité doivent servir les mêmes données en IPv4 et IPv6.
- Et pour être sûr de pouvoir passer des données de grande taille, sans compter sur la fragmentation, tous les serveurs doivent accepter TCP (RFC 9210).
Pour les résolveurs :
- Dans presque tous les cas, le résolveur devrait pouvoir parler IPv4 et IPv6.
- Si le résolveur n'a qu'IPv6 (ce qui sera de plus en plus fréquent), il faut qu'il puisse utiliser un mécanisme de coexistence qui lui permette de résoudre des zones purement IPv4 (par exemple RFC 6146, peut-être avec RFC 8781, ou bien en étant capable de faire suivre à un autre résolveur ayant tout ce qu'il faut).
- Pour les résolveurs simplifiés (stub
resolvers), comme celui dans la
libc, il faut s'assurer que les résolveurs
complets à qui ils transmettent leurs requêtes savent faire IPv4
et IPv6 (en indiquer plusieurs, par exemple dans
/etc/resolv.confsur Unix, ne marche pas bien, en raison de la limite sur leur nombre mais aussi du retard que cela entraine).
Le RFC ne semble pas en parler mais je tiens à ajouter une de mes obsessions personnelles : il faut superviser automatiquement vos serveurs DNS, en IPv4 et IPv6. Voici par exemple la configuration que j'utilise avec Icinga :
apply Service "dns-auth4" {
  check_command = "dig"
  assign where host.address && host.vars.dns_auth
  vars.dig_server = host.address
  vars.dig_ipv4 = true
  …
}

apply Service "dns-auth6" {
  check_command = "dig"
  assign where host.address6 && host.vars.dns_auth
  vars.dig_server = host.address6
  vars.dig_ipv6 = true
  …
}

object Host "mononoke" {
  address = "mononoke.bortzmeyer.org"
  address6 = "mononoke.bortzmeyer.org"
  vars.dns_auth = 1
  …
}
Et le serveur DNS sera alors testé avec les deux versions d'IP.
L'annexe A du RFC résume les changements depuis le RFC 3901 :
- Longue discussion sur la question de la fragmentation,
- Et surtout recommandation d'avoir les deux versions d'IP partout (et de le tester).
L'article seul
RFC 9998: Report from the IAB/W3C Workshop on Age-Based Restrictions on Content Access
Date de publication du RFC : Juin 2026
Auteur(s) du RFC : M. Nottingham, M. Thomson
Pour information
Première rédaction de cet article le 3 juillet 2026
En octobre 2025, l'IAB et le W3C ont organisé un atelier à Londres sur la restriction d'accès à des services Internet en fonction de l'âge. Ce RFC est le compte-rendu de l'atelier. En tant que compte-rendu, il n'exprime donc pas une position officielle de l'IAB.
Le sujet est d'actualité, avec de nombreux politiciens qui proposent d'interdire les réseaux sociaux ou la pornographie aux mineurs. Des lois sont déjà votées, comme en Australie. L'UE a un plan en cours et un projet de logiciel. Vous pouvez consulter le site du projet logiciel. En France, où l'une des questions secondaires était la compatibilité d'un éventuel contrôle avec le droit européen, un arrêt du 16 juin 2026 de la Cour de justice de l’Union européenne a estimé que la France pouvait obliger des sociétés basées dans un État membre à mettre en place une vérification d’âge.
L'atelier
devait explorer les différents techniques et choix
d'architecture liés à ce désir de restriction. Comment combiner
cette exigence de restriction aux mineurs tout en préservant les
principes d'universalité et de décentralisation de l'Internet, ainsi
que la vie privée ? Comment le faire sans mettre en place un
système de contrôle qui fera le bonheur de gouvernements
autoritaires voire dictatoriaux ? Et faut-il déléguer la sécurité
des enfants aux opérateurs Internet, plutôt qu'aux adultes qui s'en
occupent (parents, enseignants, etc) ? Les politiciens qui réclament
des restrictions d'âge « pour protéger les enfants » ne se posent
évidemment jamais ces questions (et les avertissements
des experts sont systèmatiquement ignorés). Un exemple
non technique : ces restrictions peuvent servir à un gouvernement
religieux et/ou réactionnaire pour bloquer l'accès à des sites Web
LGBT, au détriment des mineurs en
questionnement qui voudraient s'informer (notez que le RFC ne
mentionne pas ce point). L'atelier n'a pas essayé de traiter les
problèmes politiques, mais uniquement d'analyser les techniques
existantes et de pointer leurs caractéristiques et leurs
conséquences. Comme indiqué au début, cet atelier a été l'occasion
d'exprimer des points de vue variés (sous la règle de
Chatham House), ce RFC ne prétend pas en faire un synthèse, ni
donner La Bonne Réponse. Le RFC inclut notamment une liste des
propriétés attendues d'une « bonne » solution, dans l'annexe D. Ce
point de départ d'un vrai cahier des charges manque dans la plupart
des discours politiciens, où on ne fait que répéter des slogans,
sans dire clairement quels sont les avantages attendus et les
inconvénients acceptables. (L'annexe C est une intéressante liste
des impacts - positifs ou négatifs - possibles du contrôle d'âge.)
L'agenda complet de l'atelier figure dans l'annexe A du RFC, la liste des participants dans l'annexe B. Passons maintenant au contenu.
Les « solutions » techniques peuvent être mises en œuvre dans le
terminal de l'utilisateurice, dans le réseau (par exemple dans le
résolveur DNS) ou bien dans le
service (regardez https://fr.pornhub.com/
depuis la France, pour voir ; n'hésitez pas, c'est
SFW). Dans le terminal ? Cela donne du
pouvoir à Microsoft ou
Google et encourage les systèmes
privateurs sur lesquels l'utilisateurice n'a
aucun contrôle. (Encore que le logiciel libre
peut aussi, par souci de conformité et pour se faire bien voir des
politiciens, mettre en œuvre
ces contrôles.) Dans le réseau ? Cela met en danger le cœur
de l'Internet. Et cela donne du pouvoir aux acteurs de
l'infrastructure. Et ce n'est pas très précis (pensez au cas d'un
foyer où il y a adultes et enfants mais une seule adresse IP). Dans
les services ? Cela met le problème sur le dos de chaque
webmestre.
L'atelier a examiné quelques technologies « miracle » censées permettre de vérifier l'âge tout en préservant la vie privée (comme les ZKP). Même si elles résolvaient parfaitement le problème de vie privée, elles laissent ouverts les autres problèmes. Et ces technologies sont souvent récentes et leur sécurité n'est pas toujours testée en profondeur.
Bref, l'atelier n'a pas débouché sur une « solution » ni même sur un plan de travail pour l'IETF. La question reste très ouverte.
Le RFC pointe en section 3 les aspects les plus importants de ce sujet. D'abord, le fait que l'atelier a été utile car, alors que le sujet a bénéficié de nombreux articles dans la presse généraliste, et de nombreux discours politiciens, les discussions techniques ont été rares, de même que les forums impliquant toutes les parties prenantes. Et quand des techniciens étaient consultés, c'était toujours du point de vue des services, jamais de celui de l'infrastructure.
Ensuite, les discussions sont souvent peu productives car il y a eu peu d'efforts pour identifier les différentes rôles impliqués (cf. la présentation d'Hanson) :
- Le vérificateur qui doit tester si une personne donnée a plus que l'âge requis,
- Le contrôleur qui doit empêcher une personne qui a « raté » le test précédent d'accéder au service,
- Le sélecteur de politique, qui définit la politique à appliquer (elle dépend en général du pays de résidence du client, qui est difficile à déterminer sur l'Internet),
- Et le classificateur qui doit déterminer si un contenu donné ou un certain service doit être restreint d'accès.
Cette question est aussi liée à celle de la terminologie, souvent peu définie. (Tiens, j'apprends dans le RFC qu'il existe une norme ISO sur la vérification d'âge, ISO/IEC 27566-1:2025, évidemment pas accessible aux mineurs - il faut laisser plein de données personnelles pour l'obtenir.)
Autre sujet mis en évidence à l'atelier, l'importance de la préservation de la vie privée. Cette exigence est largement méprisée par les défenseurs du contrôle d'âge, le record de connerie ayant récemment été battu par une parlementaire canadienne qui affirmait que la reconnaissance faciale respectait l'anonymat puisque le logiciel ne connaissait pas le nom de la personne. Une partie des acteurs cités plus haut va connaitre des informations personnelles sur les clients des services, et ces acteurs ne sont pas forcément connus de ces clients. Imaginez que vous alliez sur un site Web de contenu pour adultes puis soudainement vous êtes redirigé vers le site Web du vérificateur qui va vous demander de prouver votre âge. Si vous êtes raisonnablement prudent, vous refusez. Si vous tenez à voir le contenu, vous répondez et voilà : on a habitué les utilisateurs à faire confiance à des sites inconnus et inattendus. Une vraie aide au hameçonnage.
En parlant de confiance, un des points difficiles de toute solution technique au problème du contrôle d'âge est la nécessité de faire confiance à de nouveaux acteurs. Certes, il existe des méthodes mathématiques pour prouver quelque chose sans divulguer d'information mais elles sont récentes, peu testées, et sont loin d'épuiser le problème de la confiance. Le fait que beaucoup de techniques proposées ne soient pas en logiciel libre n'arrange rien. (Le RFC ne mentionne pas ce point, sauf pour enfoncer une porte ouverte en rappelant que le logiciel libre ne résout pas tous les problèmes de confiance.)
Les participants à l'atelier ont aussi noté qu'il y avait peu de chances qu'une seule technique suffise : toutes ont des défauts graves. Les techniques reposant sur des documents étatiques écartent les gens qui n'en ont pas, ou ceux qui ont des documents non reconnus. Les techniques probabilistes d'estimation de l'âge (par exemple par examen du visage) ont beaucoup de faux positifs et de faux négatifs (et, pire, cela dépend de la couleur de peau). Une approche possible serait d'essayer successivement plusieurs techniques, en commençant par les moins invasives (mais cela créerait une discrimination envers les catégories de population qui échouent à ces premières techniques).
L'imperfection de toutes ces techniques a des conséquences sérieuses : exclusion de certaines personnes, contournement par d'autres (certains utilisateurs de contenu « pour adultes » n'ont pas l'âge mais sont motivés, techniquement compétents et ont du temps libre).
La plupart des architectures proposées ajoutent des parties à la relation traditionnelle entre le visiteur d'un site Web et le site en question, notamment le vérificateur et le contrôleur. On complique donc l'architecture du Web en ajoutant de nouvelles dépendances.
Et, bien sûr, la technique n'est pas tout. La sécurité des mineurs ne doit pas dépendre uniquement de techniques dont l'atelier a largement montré la fragilité. Le problème, il est vrai, est très difficile puisqu'il faut à la fois protéger les mineurs contre les dangers bien réels, tout en les préparant à leur future vie de majeur, où il n'y aura pas de restrictions techniques. Les contrôles techniques sont forcément grossiers et binaires, et ne prennent pas en compte toutes les nuances du monde. Il ne faudrait surtout pas déléguer des tâches aussi complexes et délicates que l'éducation à des « solutions » techniques.
Quelques autres ressources :
- La vidéo de présentation de l'atelier.
- Les documents présentés à l'atelier.
- La prise de position de l'Internet Society.
- Un précédent Internet-Draft sur les conséquences d'une restriction d'âge pour l'Internet.
L'article seul
RFC 9991: Domain-Based Message Authentication, Reporting, and Conformance (DMARC) Failure Reporting
Date de publication du RFC : Mai 2026
Auteur(s) du RFC : S. Jones (DMARC.org), A. Vesely (Tana)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF dmarc
Première rédaction de cet article le 20 mai 2026
DMARC (RFC 9989)
permet de demander l'envoi, par les destinataires des messages, de
rapports indiquant les éventuels problèmes notés, afin de diminuer
le nombre de faux positifs (messages légitimes incorrectement
considérés comme invalides). Cette demande de rapports se fait en
ajoutant l'option ruf à l'enregistrement
DMARC. Ce RFC
décrit ces rapports.
Il y a au moins deux raisons de demander ces rapports :
- Comprendre pourquoi certains des messages qu'on envoie sont classés comme invalides alors qu'ils ne devraient pas l'être. On va donc analyser des rapports concernant des messages qu'on a réellement envoyés.
- Détecter les tentatives d'usurpation du domaine. On va donc analyser des rapports concernant des messages qu'on ne connaissait pas, et qu'un méchant a envoyés.
Notez qu'il existe aussi des rapports agrégés (RFC 9990, avec un format très différent, fondé sur XML) et qu'on demande parfois des rapports individuels parce qu'on note dans les rapports agrégés qu'il y a beaucoup d'erreurs et qu'on voudrait comprendre leur origine.
Le format normalisé ici dérive du format ARF (Abuse
Reporting Format, RFC 6591), qui
décrivait les rapports pour les problèmes SPF et DKIM. L'option
ruf dans l'enregistrement DMARC (RFC 9989, section 4.7) indique à quelle adresse de
courrier le
rapport doit être envoyé. Voici par exemple l'enregistrement DMARC
de afnic.fr :
dig +short _dmarc.afnic.fr TXT
"v=DMARC1; p=quarantine; pct=100; ruf=mailto:dmarc-feedback@afnic.fr; rua=mailto:dmarc-feedback@afnic.fr; fo=1"
Vous voyez le ruf ? Il indique que les rapports
doivent être envoyés à
dmarc-feedback@afnic.fr. Attention, j'ai écrit
« doivent » mais, évidemment, les récepteurs de courrier ne sont
pas obligés d'envoyer ces rapports, qui peuvent
leur coûter des ressources et poser des problèmes de vie privée.
Pour DMARC, notre RFC ajoute au format du RFC 6591 les champs (section 4, ils sont listés dans un registre IANA) :
Identity-Alignment:, qui liste les mécanismes d'authentification où il n'y a pas d'alignement avec l'expéditeur,Delivery-Result:,DKIM-Domain:, et quelques autres au sujet de DKIM,SPF-DNS:.
Il y a un autre piège avec les rapports, c'est la possibilité
d'indiquer dans ruf l'adresse de quelqu'un
d'autre, pour l'embêter avec beaucoup de rapports qui ne le
concernent pas. La section 4 du RFC 9990
explique les précautions que devrait prendre un receveur de courrier
avant d'envoyer un rapport vers une adresse qui n'est pas dans le
domaine concerné, comme de tester le sous-domaine
_report._dmarc. (Dans l'exemple
afnic.fr plus haut, il n'y avait pas de
problème, le destinataire des rapports est dans le domaine
concerné.)
J'ai mentionné un peu plus haut la question de la vie privée. Les rapports détaillés, contrairement à leurs copains agrégés du RFC 9990, peuvent être très indiscrets, notamment parce qu'ils contiennent souvent des données personnelles, par exemple dans les champs indiquant l'expéditeur et le destinataire. Et il ne suffit pas de se dire « Bon, de toute façon, le gestionnaire du système envoyeur avait accès au message quand il est parti de son système » car le message a pu être transmis et re-transmis et le rapport donnera des informations sur des destinataires finaux. Une section 7, très détaillée, couvre donc ce problème. Elle note par exemple que beaucoup de gros receveurs de courrier n'envoient pas du tout de rapport individuel, seulement des rapports agrégés. Et elle recommande que, même si on envoie les rapports, on en supprime les éléments les plus sensibles (voir le RFC 6590).
Enfin, à envoyer un rapport par message, on noiera l'expéditeur supposé sous des rapports qui concerneront des spams envoyés en nombre. Donc, prudence.
Un point amusant, que je vois pour la première fois dans un
RFC : ce RFC 9991 recommande de modifier les URL présents dans les rapports en
remplaçant http par
hxxp. Cette convention est assez courante dans
le monde de la sécurité Internet, pour éviter qu'un humain ne clique
trop vite sur un lien malveillant.
L'annexe A du RFC donne un exemple de rapport, je ne montre ici que la partie MIME qui concerne le rapport proprement dit :
--=_mime_boundary_
Content-Type: message/feedback-report
Content-Transfer-Encoding: 7bit

Feedback-Type: auth-failure
Version: 1
User-Agent: DMARC-Filter/1.2.3
Auth-Failure: dmarc
Authentication-Results: gen.example;
  dmarc=fail header.from=consumer.example
Identity-Alignment: dkim
DKIM-Domain: consumer.example
DKIM-Identity: @consumer.example
DKIM-Selector: epsilon
Original-Envelope-Id: 65E1A3F0A0
Original-Mail-From: author=gen.example@forwarder.example
Source-IP: 192.0.2.2
Source-Port: 12345
Reported-Domain: consumer.example
Le message prétend venir de consumer.example
mais aucune signature DKIM n'est valide, sans doute suite à des
modifications chez forwarder.example ou bien
parce que la clé DKIM n'a pu être récupérée dans le DNS.
Apparemment, OpenDKIM est capable de générer ces rapports, mais je n'ai pas testé.
L'article seul
RFC 9989: Domain-based Message Authentication, Reporting, and Conformance (DMARC)
Date de publication du RFC : Mai 2026
Auteur(s) du RFC : T. Herr (Valimail), J. Levine (Standcore)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF dmarc
Première rédaction de cet article le 20 mai 2026
DMARC est une technique
d'authentification du courrier
électronique qui permet à un domaine d'indiquer quelle
est sa politique de sécurité vis-à-vis des messages dont
l'expéditeur (le champ From: de l'en-tête)
indique ce domaine. Il donne au gérant du domaine la possibilité
d'annoncer sa politique de sécurité « tous les messages de ce
domaine sont authentifiés (via SPF ou DKIM) ». Typiquement, DMARC est le couronnement
d'une démarche de sécurité du courrier, ce qu'on annonce quand on a
bien tout authentifié. Par contre, attention, en authentifiant la
donnée visible par les utilisateurs et pas les données techniques,
il casse certains usages du courrier. DMARC était à l'origine
normalisé dans le RFC 7489, que ce nouveau
RFC
remplace. Mais rassurez-vous si vous avez déjà déployé DMARC : les
changements ne sont pas radicaux. Le principal est le nouvel
algorithme pour trouver l'enregistrement DMARC pertinent (celui à
l'apex du domaine enregistré).
Revenons sur les problèmes de sécurité du courrier électronique. Un message typique, tel que normalisé par le RFC 5322, comprend dans son en-tête ce genre d'informations :
Date: Wed, 18 Mar 2026 17:28:36 +0800
From: Jiankang Yao <yaojk@cnnic.cn>
To: 125attendees@ietf.org
Subject: [125attendees] Wednesday 8:00 pm, Shenzhen light show for IETF 125
X-Mailer: iPhone Mail (21D61)
[et bien d'autres]
Une qui nous intéresse particulièrement est l'expéditeur. Cette
notion est plus compliquée qu'il n'y parait (il y a plusieurs
définitions possibles de « expéditeur ») mais pour DMARC, c'est
simple : le champ qui nous intéresse est uniquement le
From: (section 3.6.2 du RFC 5322). C'est en effet celui qui est typiquement affiché
par les MUA, et
c'est celui que DMARC va protéger. On l'appelle souvent RFC5322-From
pour le distinguer de celui qui apparait dans l'enveloppe du
courrier, le RFC5321-From (et qui n'est pas montré dans mon
exemple).
Les techniques d'authentification existantes avant DMARC,
SPF (RFC 7208) et DKIM (RFC 6376),
n'authentifient pas ce champ mais d'autres (le
RFC5321-From pour SPF et le domaine indiqué dans la signature pour
DKIM), qui ne sont pas en général affichés à l'utilisateurice
final·e. DMARC va permettre d'utiliser ces deux techniques, SPF et
DKIM, pour les appliquer à l'expéditeur (RFC5322-From). Un test
DMARC réussi signifie que SPF ou DKIM a réussi
mais aussi que le domaine authentifié par SPF ou DKIM est le même
que celui présent dans le From: ; on parle
d'alignement du nom de domaine. Cela ne va pas
de soi car il y a de nombreux usages légitimes
du courrier où ces domaines ne sont pas alignés, et DMARC casse donc
ces usages.
Dans les exemples de messages reçus après traitement par DMARC,
on va regarder les champs
Authentication-Results. Normalisés dans le RFC 8601, ils sont ajoutés par le récepteur et
indiquent le résultat d'une technique d'authentification. Ici, un
exemple où SPF et DKIM ont marché (tous les exemples ici sont réels,
issus de mes boites aux lettres):
Authentication-Results: mail.bortzmeyer.org; dmarc=pass (p=quarantine dis=none) header.from=afnic.fr
Authentication-Results: mail.bortzmeyer.org;
        dkim=pass (2048-bit key; secure) header.d=afnic.fr header.i=@afnic.fr header.a=rsa-sha256 header.s=afnic-20240601
        header.b=bdGM6W8o;
        dkim-atps=neutral
Authentication-Results: mail.bortzmeyer.org; spf=pass (sender SPF authorized) smtp.mailfrom=afnic.fr
        (client-ip=2001:67c:2218:10::51:1; helo=mx1.nic.fr; envelope-from=quelqu.un@afnic.fr; receiver=bortzmeyer.org)
Le domaine afnic.fr a bien été authentifié, à
la fois par SPF et par DKIM, et DMARC passe donc (le champ
From: n'est pas montré ici mais il indiquait
bien une adresse @afnic.fr).
Il est également important de se souvenir que DMARC ne fait
qu'authentifier le
domaine, il ne garantit pas que le message soit sincère, sûr, utile ou quoi
que ce soit d'autre. Si on reçoit un message de
Trump, on peut prouver qu'il vient bien de
whitehouse.gov mais il sera quand même
certainement mensonger. C'est pour cela qu'il est absurde, comme on
le lit dans certains forums, de dire « je ne comprends pas, j'ai
bien mis un enregistrement DMARC et mes messages finissent quand
même dans la boite Spam » : les spammeurs font du DMARC, eux aussi.
L'inverse est vrai aussi, un message légitime et désiré peut parfaitement échouer au test DMARC, d'autant plus, que, comme indiqué plus haut, DMARC casse plusieurs usages légitimes du courrier. Il vaut donc mieux ne pas refuser un message uniquement sur la base d'un échec DMARC mais traiter cet échec comme une indication parmi d'autres. Ce RFC 9989 insiste sur ce point (notamment sa section 7), en mentionnant également le RFC 7960, qui détaille les problèmes venant de l'utilisation de DMARC.
La section 2 du RFC détaille le cahier des charges de DMARC. Comme avec toutes les solutions de sécurité, il faut garder en tête ce cahier des charges lorsqu'on évalue DMARC. Aucune solution de sécurité n'est parfaite : elles collent simplement plus ou moins bien à leur cahier des charges. Celui-ci, en résumé, est :
- Permettre aux gérants de noms de domaine d'annoncer leur politique d'authentification du courrier et leurs souhaits quant au traitement du courrier qui ne passerait pas cette authentification.
- Fonctionner dans le contexte de l'Internet (donc, sans autorité centrale).
- Traiter uniquement les cas où le message malveillant copie
exactement un nom de domaine qu'on gère. En d'autres termes, les
usurpations utilisant des noms qui ressemblent
(
goog1e.comau lieu degoogle.com) sont hors-sujet. - Authentifier uniquement le nom de domaine qui est dans
l'adresse (RFC 5322, section 3.4). En d'autres termes, dans un
From:« Emmanuel Macron<emmanuel5561@gmail.com>, DMARC ne se préoccupe que dugmail.com, pas duemmanuel5561. - Authentifier uniquement l'adresse, pas le nom affiché (« Emmanuel Macron » dans l'exemple ci-dessus). La section 11.4 rappelle ce point très important.
Un bon cahier des charges a une autre section très importante : celle des non-objectifs, des choses qu'on n'essaie pas de faire. (Regardez les documents commerciaux : ils n'ont jamais l'honnêteté de lister ce qu'ils ne font pas.) Pour DMARC :
- Il ne dit évidemment rien sur les domaines qui ont choisi de ne pas avoir d'enregistrement DMARC dans le DNS. Dit autrement, DMARC est opt-in.
- Il n'essaie pas de s'occuper des autres informations
présentes dans l'en-tête (comme
Reply-To:ouDate:). - Il ne s'occupe pas des tricheries sur le nom affiché, comme
dans l'exemple « Emmanuel Macron » plus haut (ou bien, tiré de ma
boite Spam
From: "amendes.gouv.fr"
    <amendes-gouv-nepasrepondre.C9717A5D-EA39-D865-765A6C98B4A0BB03@therugest.com>
). Tant pis pour ceux et celles qui s'obstinent à utiliser un logiciel qui, par défaut, n'affiche que ce nom (Outlook fait encore ça). Relisez la section 11.4 du RFC. - Et naturellement, DMARC ne s'occupe pas du contenu du message, qu'il soit mensonger (« je suis l'ex-ministre des finances du Nigéria ») ou malveillant (logiciel qui va tenter d'exploiter une faille de sécurité pour prendre le contrôle de votre ordinateur).
Par exemple, voici un spam, prétendant venir de l'ANTAI mais qui passe tous les tests (le nom de domaine dans l'adresse n'a rien à voir avec l'ANTAI mais beaucoup d'utilisateurs n'y feront pas attention, et ce nom avait bien un enregistrement DMARC) :
Authentication-Results: mail.bortzmeyer.org; dmarc=pass (p=quarantine dis=none) header.from=rtm.gov.my
Authentication-Results: mail.bortzmeyer.org;
        dkim=pass (2048-bit key; secure) header.d=rtm.gov.my header.i=@rtm.gov.my header.a=rsa-sha256 header.s=rtm
        header.b=MaKApt+s;
        dkim-atps=neutral
DKIM-Signature: v=1; a=rsa-sha256; c=relaxed/relaxed;
        d=rtm.gov.my; s=rtm; t=1775231898; x=1775836698; darn=bortzmeyer.org;
        h=content-transfer-encoding:mime-version:subject:message-id:to:from
        :date:from:to:cc:subject:date:message-id:reply-to;
        bh=L6c3f6fDBrQyBjkO1RiiF3vHHNmYjLDd4A1urn+cNJg=;
        b=MaKApt+s0vgkVsgh3VoFE0/MgCt8ilWkghyQKUbj2NnhgInADkR8G3aW0UbklkuDDV
	…
Authentication-Results: mail.bortzmeyer.org; spf=pass (sender SPF authorized) smtp.mailfrom=rtm.gov.my
        (client-ip=2607:f8b0:4864:20::f64; helo=mail-qv1-xf64.google.com; envelope-from=antai.gouv.fr@rtm.gov.my;
        receiver=bortzmeyer.org)
Subject: ACTION REQUISE SOUS 24H
From: "Antai.gouv.fr" <Antai.gouv.fr@rtm.gov.my>
La section 3 du RFC décrit les termes utilisés par DMARC, entre autres :
- Domaine de l'auteur : ce qui est après
l'arobase dans l'adresse indiquée par le
champ
From:de l'en-tête (rappel : pas celui de l'enveloppe). - Domaine DKIM : celui indiqué par le paramètre
d=dans la signature DKIM (rappel : le domaine DKIM peut n'avoir aucun rapport avec l'adresse de l'en-tête ou avec celle de l'enveloppe). - Domaine SPF : ce qui est après
l'arobase dans l'adresse indiquée par le
champ
Fromde l'enveloppe (rappel : pas celui de l'en-tête). Dans le contexte de DMARC, ce terme ne s'applique pas au domaine indiqué dans la commande EHLO (ou HELO) de SMTP. - Titulaire du domaine : la personne physique ou morale qui décidé d'enregistrer un nom de domaine et qui le gère ensuite.
- Domaine organisationnel : le domaine au sommet du sous-arbre
qui a la même administration (le RFC 5598
est une bonne lecture ici). Ainsi,
bortzmeyer.orgest le domaine organisationnel demail.bortzmeyer.org. En pratique, c'est souvent le domaine enregistré du RFC 9499, domaine qui a été enregistré auprès d'un registre. - Suffixe public : domaine où le public peut enregistrer un
sous-domaine, par exemple
.froueu.org. Ainsi, dansmail.foobar.eu.org,foobar.eu.orgest le domaine organisationnel eteu.orgle suffixe public, ou domaine d'enregistrement.
Armé de cela (mais il y a d'autres termes, que je présenterai au fur et à mesure), on peut passer à la section 4, qui explique les concepts importants.
DMARC permet à un titulaire de domaine d'annoncer sa politique
d'authentification d'un domaine de l'auteur d'un courrier. On
n'authentifie donc que le domaine, pas toute l'adresse (je l'ai déjà
dit mais c'est important). Et DMARC ne s'intéresse qu'à ce qu'il
appelle le domaine de l'auteur, donc le From:
dans l'en-tête (également appelé « RFC5322.From »). DMARC annonce
juste une politique, l'authentification est faite avec SPF (RFC 7208) ou DKIM (RFC 6376).
Un concept essentiel dans DMARC est celui
d'alignement. Il y a alignement quand le
domaine authentifié par SPF (celui de l'enveloppe, le
« RFC5321.From ») ou par DKIM (celui indiqué dans le
d= de la signature) coïncide avec le domaine de
l'auteur (celui du From: de l'en-tête). Plus
précisément, il peut y avoir un alignement strict (les deux noms de
domaine sont identiques) ou relâché (les deux noms sont dans le même
domaine organisationnel). Le choix se fait dans l'enregistrement
DMARC publié.
Justement, on le publie où ? Via le DNS, dans un enregistrement de type TXT, publié
dans le sous-domaine _dmarc, par exemple :
% dig +short _dmarc.proton.me TXT
"v=DMARC1; p=quarantine; fo=1; aspf=s; adkim=s;"
On bénéficie ainsi de toute l'infrastructure,
très fiable et éprouvée, du DNS. Ce sous-domaine
_dmarc figure dans le
registre IANA des noms commençant par un trait bas, créé par le RFC 8552.
Au passage, si vous voulez voir (ou enregistrer), sur un serveur DNS faisant
autorité, uniquement les requêtes DNS pour le sous-domaine
_dmarc, dnscap permet
de le faire facilement :
% dnscap -g -x _dmarc
(Je triche un peu, le -x attrape en effet
davantage que cela mais ça suffit en première approximation.)
Le format exact de l'enregistrement DMARC utilise des doublets clé=valeur, comme celui de DKIM. (Sa description formelle, en ABNF - RFC 5234 - est dans la section 4.8.) Les clés possibles figurent dans un registre IANA. Les plus courantes sont :
v: c'est obligatoirement le premier doublet clé=valeur et il indique la version de DMARC, actuellementDMARC1.p: c'est la clé la plus importante, celle qui indique la politique à appliquer aux messages qui ne passent pas la validation DMARC. Une valeurrejectindique que le titulaire du domaine recommande le rejet des messages invalides (cela ne peut être qu'une recommandation, car le récepteur du courrier reste évidemment libre de sa politique).quarantinerecommande une mise en attente quelque part (un dossier « peut-etre-spam » par exemple). Enfin,noneindique qu'on recommande de ne rien faire. Cela peut être utilisé quand on craint les conséquences de DMARC sur certains usages (cf. RFC 7960) mais qu'on pense que certains récepteurs vont mal traiter les messages des domaines sans DMARC. Ou bien cela peut être utile dans certains audits « de sécurité » qui demandent un enregistrement DMARC, n'importe lequel. Enfin, unp=nonepeut être utilisé lors d'un déploiement progressif de DMARC, quand on veut juste tester, avant de publier une politique plus fasciste. Comme DMARC permet de solliciter l'envoi de rapports d'erreur, unp=nonepeut être accompagné d'une telle sollicitation.sp: commepmais pour les sous-domaines du domaine qui a l'enregistrement DMARC. Les valeurs possibles sont les mêmes que pourp.np: nouveauté, initialement décrite dans le RFC 9091. C'est le traitement à appliquer aux sous-domaines non existants du domaine pour lequel une politique DMARC est publiée. Les valeurs possibles sont les mêmes que pourp.ruf: c'est ainsi qu'on sollicite l'envoi de rapports d'erreur. On indique les URI où envoyer ces rapports (souvent des URI de planmailto:, pour demander des rapports par courrier). Le format des rapports est spécifié dans les RFC 9991, RFC 6651 et RFC 6552.rufdemande un rapport par message invalide,ruapermet de demander des rapports agrégés. Leur format figure dans le RFC 9990.psd: nouveauté de notre RFC, s'il a la valeury, il indique que le domaine est un suffixe public (PSD : Public Suffix Domain), c'est-à-dire un domaine dont les sous-domaines peuvent être délégués à d'autres entités (comme c'est le cas de.reoueu.org).fo: diverses options pour la génération de rapports d'erreur.adkimetadpf: tous les deux peuvent prendre la valeurs(strict) our(relâché, ou laxiste). Ils indiquent si l'alignement duFrom:avec l'identificateur authentifié par DKIM ou SPF doit être strict (les deux identificateurs sont rigoureusement identiques) ou relâché (l'identificateur authentifié peut se contenter d'être dans le même domaine enregistré que celui qui a un enregistrement DMARC). Par défaut, DMARC est laxiste. Notez que cela permet à quelqu'un qui peut utiliser un sous-domaine de se faire authentifier comme étant dans l'apex (section 11.8 du RFC). Demander un alignement strict résout ce problème (mais impose que vous contrôliez bien les sous-domaines).
Les clés inconnues doivent être ignorées, ce qui permet d'en ajouter de nouvelles sans tout casser. La politique pour un éventuel ajout est « Spécification nécessaire » (RFC 8126).
On a parlé du domaine organisationnel, l'apex du domaine testé
par DMARC. C'est en fait une notion administrative, pas technique,
ce qui fait que ce domaine organisationnel n'est pas évident à
identifier dans le DNS. Pour le trouver, l'ancien RFC, le RFC 7489, suggérait de faire appel à une liste de suffixes
publics, comme la PSL (rappel : il n'existe
pas de liste officielle). Notre nouveau RFC suggère une autre
méthode, en remontant l'arbre des noms de domaine. On commence par
le domaine qu'on veut authentifier, et, si on n'y trouve pas de
politique DMARC, on essaie son domaine parent et ainsi de suite,
jusqu'à ce qu'on trouve un enregistrement DMARC. Ainsi, pour
truc.machin.example.com, on essaiera
successivement _dmarc.truc.machin.example.com,
_dmarc.machin.example.com,
_dmarc.example.com et enfin
_dmarc.com. La dernière requête permet donc au
registre de
.com de définir une
politique DMARC qui s'appliquera à tous les domaines sans politique
DMARC. C'est très dangereux, pour les raisons expliquées dans le
RFC 1535 mais cela permet de se passer de
liste de suffixes publics, et c'est plus souple pour le cas des
grosses organisations, qui peuvent avoir des politiques DMARC dans
des sous-domaines qui ne sont pas délégués.
Notez que l'éventuelle présence de la clé
psd va compliquer les choses mais je n'ai pas
vraiment le courage de détailler ici l'algorithme complet.
Maintenant, voyons quels sont les acteurs d'un déploiement de
DMARC. D'abord, le titulaire du domaine qui envoie des messages. Il
doit publier un enregistrement SPF à l'apex du domaine. Il doit
signer les courriers sortants avec DKIM (ce qui implique de publier
les clés publiques DKIM dans le DNS). Notez que DMARC n'a pas besoin
de SPF et de DKIM, un seul des deux suffit
mais, bon, autant tout faire. Il a intérêt à créer une boite dédiée
pour recevoir les rapports sur les messages invalides. Le titulaire
doit enfin publier dans le DNS l'enregistrement DMARC (celui qui
commence par _dmarc). Au début, on utilise
typiquement une politique indulgente
(p=none). Puis on teste.
Comment teste-t-on ? En lisant les rapports indiquant des
messages invalides (RFC 9990 et RFC 9991). Les
rapports agrégés sont du
XML, assez
lisibles par un humain mais, en pratique, on préférera typiquement
utiliser un programme qui les synthétisera dans une forme plus
lisible. (Je n'utilise pas actuellement un tel programme, car je
n'en ai pas trouvé. Il faut qu'il tourne en local - pas question de
confier les rapports à un tiers - et ne nécessite pas d'installer
toute une batterie de cuisine PHP et MariaDB.)
Une fois qu'on a trouvé les problèmes (une application oubliée dans
un coin qui envoie des courriers sans passer par les serveurs
centraux…) et qu'on les a corrigés, on peut durcir la politique
(p=quarantine, par exemple). Il est raisonnable
d'attendre plusieurs semaines, voire mois, pour être sûr d'avoir vu
tous les problèmes.
(Et si vous êtes gérant d'un suffixe public - un domaine sous
lequel d'autres entités peuvent enregistrer des noms, demandez-vous
si vous devez publier du DMARC avec psd=y. Ce
n'est pas obligatoire, cf. section 5.2.)
Et le récepteur du courrier, que doit-il faire ? Il extrait du message le domaine de l'auteur. Il cherche s'il y a un enregistrement DMARC. Il exécute les tests SPF et DKIM. S'il récupère un ou plusieurs domaines authentifiés, il vérifie l'alignement (strict ou relâché). Si au moins un domaine authentifié est aligné avec le domaine de l'auteur, le test DMARC est un succès. Sinon, c'est un échec. Notez bien qu'il n'est pas nécessaire que SPF et DKIM réussissent tous les deux. Si le test DMARC se termine en échec, on applique un traitement, qui dépend de la politique suggérée dans l'enregistrement DMARC, et de la politique propre du receveur. Voici un exemple où DMARC dit que tout s'est bien passé :
From: "Projet Arcadie" <admin@projetarcadie.com>
Authentication-Results: mail.bortzmeyer.org; dmarc=pass (p=none dis=none) header.from=projetarcadie.com
Authentication-Results: mail.bortzmeyer.org;
        dkim=pass (2048-bit key; unprotected) header.d=projetarcadie.com header.i=@projetarcadie.com header.a=rsa-sha256 header.s=alternc
        header.b=plrnZlsJ;
        dkim=pass (2048-bit key) header.d=projetarcadie.com header.i=@projetarcadie.com header.a=rsa-sha256 header.s=alternc
        header.b=m84VgM5U;
        dkim-atps=neutral
Authentication-Results: mail.bortzmeyer.org; spf=pass (sender SPF authorized) smtp.mailfrom=projetarcadie.com (client-ip=91.194.60.11;
        helo=arcadieweb01.octopuce.fr; envelope-from=admin@projetarcadie.com; receiver=bortzmeyer.org)
Ici, il y avait un enregistrement SPF (qui autorise l'émetteur
SMTP
donc cela suffit), deux signatures DKIM, toutes les deux correctes,
il y a alignement strict, et donc DMARC passe, il n'y a aucun doute
que le domaine émetteur était bien
projetarcadie.com. (La politique DMARC était
p=none donc un éventuel échec n'aurait sans
doute pas eu beaucoup de conséquences.)
Ici, DKIM a échoué (pourquoi ? mystère mais c'est peut-être la faute de SpamAssassin qui a modifié le sujet, il faudrait que je vérifie ma configuration) mais SPF réussit (le message vient bien de Gmail) donc DMARC est content (il s'agissait bien d'un spam, tentative d'escroquerie financière) :
Authentication-Results: mail.bortzmeyer.org;
        dkim=fail reason="signature verification failed" (2048-bit key; unprotected) header.d=gmail.com header.i=@gmail.com
        header.a=rsa-sha256 header.s=20230601 header.b=K6F+sj7y;
        dkim-atps=neutral
Authentication-Results: mail.bortzmeyer.org; dmarc=pass (p=none dis=none) header.from=gmail.com
Authentication-Results: mail.bortzmeyer.org; spf=pass (sender SPF authorized) smtp.mailfrom=gmail.com
        (client-ip=2a00:1450:4864:20::133; helo=mail-lf1-x133.google.com; envelope-from=mrsbalex@gmail.com;
        receiver=sources.org)
From: "Mr. Mike Christopher" <mrsbalex@gmail.com>
Et ici, un échec, SPF est correct, il n'y a pas de signature DKIM
et il n'y a pas d'alignement des domaines, la tentative du spammeur
pour se faire passer pour saison.co.jp échoue :
From: 株式会社クレディセゾン <admin@saison.co.jp>
Authentication-Results: mail.bortzmeyer.org; dmarc=fail (p=none dis=none) header.from=saison.co.jp
Authentication-Results: mail.bortzmeyer.org; spf=pass (sender SPF authorized) smtp.mailfrom=zh-cht-jjb.com (client-ip=34.130.185.194;
        helo=zh-cht-jjb.com; envelope-from=admin@zh-cht-jjb.com; receiver=bortzmeyer.org)
Et ici, l'émetteur tente de faire croire qu'il vient de
Gmail mais l'enregistrement SPF de
Gmail se termine par un ~all, son
adresse IP n'y est pas listée et il n'y a pas de signature DKIM dans
le message. Même pas besoin de tester l'alignement puisqu'il n'y a
pas de domaine authentifié du tout :
From: Axel.Bouvier <mailrmicro+Axel.Bouvier@gmail.com>
Authentication-Results: mail.internatif.org; dmarc=fail (p=none dis=none) header.from=gmail.com
Authentication-Results: mail.internatif.org; spf=softfail (domain owner discourages use of this host)
        smtp.mailfrom=gmail.com (client-ip=78.246.109.210; helo=gmail225.com;
        envelope-from=mailrmicro+axel.bouvier@gmail.com; receiver=internatif.org)
De nombreux autres exemples, avec succès ou échec, figurent dans l'annexe B du RFC.
C'est pas mal si le récepteur de courrier qui fait tourner DMARC
en profite pour générer les rapports (RFC 9991), s'ils sont
demandés (par un ruf ou un
rua dans l'enregistrement DMARC de
l'envoyeur). Néanmoins, le RFC note qu'il peut ne pas le faire, s'il
craint pour la vie privée (cf. section 10) ou tout simplement si ça
lui consomme trop de ressources.
D'ailleurs, le RFC insiste bien sur un point que j'avais déjà mentionné : la décision finale (de livrer le message, ou de le mettre dans le dossier Spam ou de le jeter) revient toujours au destinataire (section 5.4). Celui-ci applique la politique qu'il veut. Il serait ridicule de croire que, parce qu'on a SPF, DKIM et DMARC bien configurés, nos messages seraient systématiquement livrés. Après tout, un spammeur peut en faire autant.
À l'inverse, un récepteur peut parfaitement décider d'acheminer jusqu'à ses utilisateurices un message qui échoue aux testes DMARC, par exemple parce qu'il a lu le RFC 7960 (et la section 7.4 de notre RFC) et qu'il sait que DMARC échoue dans des cas d'usage pourtant légitimes, notamment les listes de diffusion. DMARC fournit de la traçabilité et de la responsabilité, il n'est pas un oracle tout-puissant sur l'authenticité du message.
La section 7 du RFC est surtout intéressante pour les historien·nes et pour les technicien·nes qui veulent comprendre les choix faits par DMARC. C'est un pot-pourri de diverses discussions.
D'abord, SPF. SPF a été conçu pour être utilisable
pendant la session SMTP, parfois avant même que l'en-tête du
message ait été transmis. Une politique SPF « dure » (se terminant
en -all) peut amener au rejet du message avant
que DMARC n'ait été évalué. Ainsi, si un message échoue en SPF mais
réussit en DKIM, normalement, DMARC réussirait. Mais, si le test SPF
mène à un rejet dès la session SMTP, le message n'arrivera
pas. Attention donc en configurant vos enregistrements SPF. (Relisez
les « M3AAWG Best
Practices for Managing SPF Records » et
« M3AAWG
Email Authentication Recommended Best
Practices ».)
Et à propos de rejet précoce (dans le cours de la session SMTP, avant d'avoir accepté le message) : le RFC recommande cette méthode car elle évite la génération d'un avis de non-remise (RFC 3464), avis qui irait sans doute à un innocent si l'adresse était usurpée. Deux façons de mettre en œuvre ce rejet précoce, en renvoyant un code d'erreur (commençant par 5 RFC 5321, section 4.2.5) au client SMTP, qui saura ainsi que son message a été refusé, ou, plus méchamment, en prétendant que le message a bien été reçu (code commençant par 2) mais en le jetant silencieusement. La deuxième solution est évidemment horrible (le serveur SMTP ment, l'émetteur ne sait pas ce qui s'est passé, le déboguage devient très difficile) mais elle est parfois nécessaire pour éviter le backscatter, l'envoi de messages d'erreur à un innocent, une des plaies du spam qui usurpe votre adresse. Et elle évite de donner des informations à quelqu'un qu'on estime être un usurpateur.
Contrairement à ce qu'on voit dans certains
articles pro-DMARC imprudents qui promeuvent DMARC sans
insister sur ses limites et ses faiblesses, notre RFC précise bien
qu'il y a des cas où DMARC pose problème (sections 7.3 et 7.4). Par
exemple, citant le RFC 7960, il rappelle que
DMARC peut casser des cas d'usage légitimes comme les adresses
d'anciens élèves que certaines universités fournissent (en faisant
suivre automatiquement le courrier à l'adresse actuelle), comme des
alias où le courrier vers une même adresse est distribuée à
plusieurs personnes, qui ne sont pas forcément dans le même domaine,
ou comme les listes de
diffusion. Pour les deux premiers cas, des solutions
relativement simples existent (réécrire l'enveloppe pour ne pas
casser SPF, ce qui est de toute façon une bonne pratique car
l'envoyeur du message ne saurait pas quoi faire si la vraie adresse
finale ne marcherait pas) et ne pas du tout toucher au message, pour
éviter de casser DKIM), pour les listes de diffusion, c'est plus
délicat. En pratique, plusieurs gestionnaires de liste adoptent la
solution très intrusive de réécrire le champ
From: comme ici dans ce message envoyé à une
liste de l'OARC (le vrai
From: a été reporté en
Reply-To:) :
Authentication-Results: nic.fr;
        spf=pass smtp.mailfrom=dns-operations-bounces@dns-oarc.net;
        dmarc=pass header.from=dns-oarc.net
Reply-To: Walter Russo <walter@secureme.it>
From: Walter Russo via dns-operations <dns-operations@dns-oarc.net>
Le problème est évidemment particulièrement sérieux si on a une
politique DMARC restrictive (p=reject) et le
RFC conseille fortement dans ce cas de systématiquement signer avec
DKIM, pour éviter de compter sur le seul SPF (qui sera cassé par les
serveurs qui font suivre un message sans réécrire l'enveloppe). Et
il rappelle aux récepteurs de courrier qu'il est très imprudent de
rejeter un message sur la seule base de DMARC. Ces consignes, qui ne
sont pas toujours respectées par les serveurs actuels, sont
cruciales pour le bon fonctionnement du courrier. Le RFC note bien
ce problème de filtrage excessif et explique que c'est ce qui a mené
plusieurs gestionnaires de liste à tripoter le champ
From:, par exemple en changeant le vrai champ
bob@example.com en un
bob=example.com@user.somelist.example, où on
peut toujours retrouver la vraie adresse. (On ajoute également
parfois un Reply-To: indiquant la vraie adresse
de l'expéditeur, comme dans l'exemple ci-dessus.) Le RFC n'approuve
pas cette modification mais note qu'elle est répandue et qu'il faut
faire avec. Il existe des solutions techniquement plus propres comme
le ARC du RFC 8617 mais que presque personne
n'utilise.
En résumé, pour faire du DMARC complet, l'émetteur du courrier devrait idéalement :
- Produire des messages qui auront un identificateur SPF aligné avec le domaine de l'auteur (une exigence qui me parait très excessive),
- produire des messages avec une signature DKIM valide et alignée,
- configurer une boite aux lettres qui recevra les rapports,
- publier l'enregistrement DMARC (je rajoute : après avoir soigneusement testé les trois points précédents),
- ne pas compter sur le seul SPF.
Et le receveur devrait idéalement :
- Tester s'il y a un enregistrement DMARC pour le domaine de l'auteur,
- tester s'il y a des identificateurs authentifiés par SPF ou DKIM,
- tester si au moins l'un d'entre eux est aligné avec le domaine de l'auteur,
- déterminer ainsi si le résultat final est pass ou fail,
- envoyer des rapports, si demandé,
- ne pas rejeter des messages juste parce
qu'il y a eu un échec DMARC, même si la politique de l'émetteur
est
p=reject.
La section 11 du RFC creuse les questions de sécurité. Que faut-il savoir pour utiliser DMARC de manière sûre ? D'abord, DMARC est évidemment dépendant des mécanismes d'authentification utilisés, SPF et DKIM (le groupe de travail IETF avait même envisagé de supprimer SPF, considéré comme trop permissif). Si vous publiez votre clé privée DKIM, DMARC ne pourra rien pour vous. Et SPF, DKIM et DMARC dépendent tous les trois du DNS donc il est crucial de gérer ses serveurs DNS sérieusement. Malheureusement, les RFC sur ces trois techniques n'imposent pas DNSSEC (RFC 9364) mais ils devraient : sans DNSSEC, l'envoi de fausses informations dans le DNS est plus facile. Compter sur SPF, DKIM et DMARC sans avoir DNSSEC me semble peu sérieux mais, bon, le vrai but de la cybersécurité est de réussir l'audit de conformité, pas d'améliorer la sécurité concrète. D'autre part, l'examen du trafic DNS (qui n'est pas limité aux deux parties qui s'envoient du courrier) donne des informations sur le trafic. Utiliser DoT (RFC 7858) ou DoH (RFC 8484) peut donc être une bonne idée.
Comme toujours en ingénierie, d'autres solutions techniques auraient été possibles. L'annexe A de notre RFC examine certaines de ces alternatives et explique pourquoi elles n'ont pas été retenues. Ainsi, on aurait pu utiliser S/MIME (RFC 8551) pour signer le message, ajoutant cette technique à SPF et DKIM. Mais S/MIME a un cahier des charges différent de celui de DMARC, il vise plutôt à une authentification de bout en bout du message entier. Et puis il faut bien constater qu'en dehors de quelques environnements bureaucratiques fermés, personne n'utilise S/MIME. C'est en partie dû à la nécessité d'une PKI, dont le RFC note qu'elle a été souvent promise mais ne s'est jamais matérialisée. (Curieusement, le RFC ne cite pas OpenPGP - RFC 9580 - qui est pourtant nettement plus utilisé que S/MIME.)
Une autre décision de conception cruciale de DMARC est le fait d'accepter n'importe quelle technique d'authentification ; SPF ou DKIM, c'est pareil pour lui. Il a pourtant été souvent proposé de permettre au titulaire du domaine de spécifier, dans l'enregistrement DMARC, de préciser qu'on ne veut que SPF, ou que DKIM. Mais DMARC est assez compliqué comme cela et la décision a finalement été de permettre l'une ou l'autre des méthodes d'authentification. Débrouillez-vous pour qu'au moins une (et de préférence les deux) fonctionne.
Un point essentiel de DMARC est qu'il authentifie l'expéditeur
(plus exactement son alignement) en
considérant que l'expéditeur est indiqué par le champ
From: de l'en-tête. Cela casse bien des usages
légitimes (comme les listes de diffusion). Ne serait-il pas
préférable d'authentifier un champ plus technique comme
Sender: (RFC 5322,
section 3.6.2) ? Cela avait même été spécifié dans le RFC 4870, puis retiré. Finalement, le choix a été
de se concentrer sur From: puisqu'il est le
seul à être toujours montré à l'utilisateur. (SPF, comme DKIM,
peuvent authentifier un identificateur que l'utilisateur ordinaire
ne voit pas.)
Notre RFC 9989 introduit une nouvelle clé,
np, qui spécifie la politique à appliquer aux
sous-domaines non existants du domaine authentifié. Cela soulève le
problème de la définition de non existant. Le RFC dit que cela
inclut les réponses NXDOMAIN (No Such Domain),
évidemment, mais pas forcément les réponses NOERROR où la section
Réponses est vide, car le nom existe mais ne contient ni
enregistrement MX, ni enregistrement d'adresse (A ou AAAA). Ce test
de la présence de certains types d'enregistrement est déjà
couramment utilisé en pratique (il n'y a aucune raison d'accepter du
courrier d'un domaine qui ne permettrait pas les réponses) mais le
RFC ne l'impose pas. Et, sinon, le RFC rappelle que, si une requête
pour un domaine renvoie NXDOMAIN, tous ses sous-domaines n'existent
pas non plus (RFC 8020).
Évidemment, un débat ancien et récurrent pour DMARC est celui des
frontières organisationnelles. Comment sait-on si
cis.cnrs.fr dépend de la même autorité que
cnrs.fr (ou bien
pick.eu.org et eu.org). Il
n'y a pas de réel moyen de trouver cette information dans le
DNS. (On peut trouver les frontières techniques
en demandant l'enregistrement de type SOA. Mais cela ne donne pas
les frontières
administratives. gouv.fr
n'est pas géré par la même organisation que fr,
même s'ils sont dans la même zone.) Des efforts ont été faits à
l'IETF
pour résoudre ce problème mais sans
résultat. L'ancien RFC DMARC, le RFC 7489 suggérait d'utiliser une liste de suffixes d'enregistrement mais
notre RFC 9989 a finalement préféré une autre méthode,
la « montée à l'arbre » (on grimpe l'arbre des noms de domaine,
cherchant des enregistrements DMARC).
Passons à la pratique, maintenant. OpenDMARC est aujourd'hui très répandu, aussi bien côté envoyeur que côté récepteur, et apparait souvent dans les articles de marketing « comment s'assurer que votre spam pardon votre newsletter sera bien livrée partout ». Sur mon serveur de messagerie personnel, j'annonce une politique DMARC et, pour valider les messages entrants, j'utilise OpenDMARC (notez que son développement semble bien avoir stoppé et qu'il y a donc peu de chances qu'il prenne en compte les nouveautés de ce RFC). Ma configuration est très proche de celle par défaut :
Socket inet:54321
# Les autres ont leur valeur par défaut
Et Postfix le lance ainsi, juste après DKIM :
smtpd_milters = unix:run/opendkim.sock, inet:localhost:54321
Et c'est ainsi que sont produits les champs
Authenticated-Results: que vous avez vus.
Pour apprendre DMARC, je recommande l'excellent et interactif https://www.learndmarc.com/
Le chemin vers ce RFC a été très long (plusieurs années). L'annexe C du RFC résume les changements depuis le précédent RFC, le RFC 7489. Les principaux sont :
- Nouvel algorithme (« montée dans l'arbre » pour trouver le domaine organisationnel, au lieu de l'utilisation d'une liste de suffixes publics). C'est la suite du RFC 9091.
- Introduction de nouveaux concepts comme le PSD (Public Suffix Domain) et le PSO (Public Suffix Operator).
- Le RFC n'est plus seulement « Pour information », il passe sur le chemin des normes.
- Plusieurs nouvelles clés sont possibles dans
l'enregistrement DMARC :
np,psdett. - Mise à l'écart de certaines clés comme
pct(partiellement remplacé part). - Résolution des erreurs du précédent RFC.
Les articles suivants sont de bonnes lectures pour les nouveautés de DMARC :
L'article seul
RFC 9987: SSH Agent Protocol
Date de publication du RFC : Mai 2026
Auteur(s) du RFC : D. Miller (OpenSSH)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF sshm
Première rédaction de cet article le 28 mai 2026
Voici encore un RFC qui normalise quelque chose qui existait depuis longtemps : le protocole Agent de SSH.
SSH est normalisé dans le RFC 4251 et il permet la connexion à distance (RFC 4253) avec authentification (RFC 4252 et RFC 4254) par exemple avec une clé publique. Il est probablement inutile de le présenter davantage aux lecteurices de ce blog. Une des fonctions géniales de SSH est la possibilité d'avoir un agent (rien à voir avec l'IA agentique qui est à la mode en ce moment) qui mémorise les clés privées et peut effectuer les opérations demandées. Ainsi mémorisées, les clés seront utilisables sans nouvelle intervention de l'utilisateur (taper une phrase de passe, etc) tout en restant bien sécurisées. Et l'agent peut intervenir sur des connexions distantes, ce qui évite de copier sa clé privée sur des serveurs à qui on ne fait pas forcément totalement confiance. L'agent ne tourne pas dans le client SSH mais dans un processus dédié, ce qui améliore sa sécurité. Si vous êtes connecté en ce moment, vous avez sans doute un agent SSH qui tourne (ici sur une Debian) :
% ps uxwww | grep ssh
bortzme+  459934  0.0  0.0  10700  4964 ?        Ss   09:44   0:00 /usr/bin/ssh-agent /home/bortzmeyer/.xsession
Comme indiqué au début, ce mécanisme d'agent est connu, mis en œuvre
et utilisé depuis très longtemps, ce RFC est une documentation a posteriori (le très ancien document
draft-ietf-secsh-agent
décrivait un protocole différent).
Donc, comment fonctionne ce protocole Agent (section 2 du RFC) ? Il est client-serveur, le serveur étant l'agent et le client de l'agent n'étant pas forcément un client SSH (mais, bon, c'est le cas le plus courant). Le client envoie des requêtes à l'agent et reçoit des réponses (comme dans beaucoup de protocoles réseau…). L'agent est un serveur pur, il ne fait que répondre au client, sans prendre d'initiatives. Les requêtes typiques sont le chargement d'une clé, la suppression d'une clé, la signature en utilisant une des clés. Le serveur reste maitre d'accepter ou pas les requêtes et le client doit donc être prêt à voir une requête refusée, par exemple parce que l'agent n'accepte que les clés d'un certain type.
La section 3 du RFC détaille les messages échangés entre le
client et l'agent (le serveur). Ils sont de type TLV et les types figurent dans
un
registre IANA. La longueur peut être nulle, par exemple il
existe des messages de type SSH_AGENT_FAILURE
(type numérique 5) qui n'ont pas de valeur. Le client demande
l'ajout d'une clé avec des messages de type
SSH_AGENTC_ADD_IDENTITY (type numérique 17). La
valeur est composée du type de la clé, de la clé elle-même et du
commentaire que vous avez indiqué lors de la création de la clé ; si
vous utilisez, par exemple, une clé Ed25519,
cf. RFC 8709, le type est
ssh-ed25519 (la liste est dans un
registre IANA). Avec OpenSSH, vous
trouverez ce commentaire dans
~/.ssh/id_ed25519.pub.
De la même façon,
on peut retirer une clé avec les messages de type
SSH_AGENTC_REMOVE_IDENTITY (type 18) et
SSH_AGENTC_REMOVE_ALL_IDENTITIES (type 19).
Une fois les clés dans l'agent, le client peut lui demander de
signer avec le type de
message SSH_AGENTC_SIGN_REQUEST (type 13),
message qui comprendra les données à signer.
Pour se
connecter à l'agent (section 4 du RFC), le client doit utiliser une
méthode sûre. Èvidemment pas question d'ouvrir l'agent à tout
l'Internet. Sur Unix, la méthode la plus
courante est d'utiliser une prise locale. Souvent, elle est trouvée
par une variable d'environnement définie lors
de la connexion, en général
SSH_AUTH_SOCK. C'est ce que fait
OpenSSH mais ce n'est pas imposé par la
norme, qui laisse le choix aux programmes.
Voici un exemple avec OpenSSH :
# On lance l'agent (on aurait normalement utilisé eval ou un
# équivalent, pour définir la variable d'environnement) :
% ssh-agent
SSH_AUTH_SOCK=/tmp/ssh-xrLh0tnpVwLF/agent.23934; export SSH_AUTH_SOCK;
SSH_AGENT_PID=23935; export SSH_AGENT_PID;
echo Agent pid 23935;

% ls -l /tmp/ssh-ZzouiZGBumyI/agent.23934
srw------- 1 stephane stephane 0 May  4 18:38 /tmp/ssh-ZzouiZGBumyI/agent.23934

% SSH_AUTH_SOCK=/tmp/ssh-xrLh0tnpVwLF/agent.23934; export SSH_AUTH_SOCK

% ssh -vvv SERVEUR-DISTANT
…
debug1: Next authentication method: publickey
debug3: ssh_get_authentication_socket_path: path '/tmp/ssh-xrLh0tnpVwLF/agent.23934'
debug1: get_agent_identities: bound agent to hostkey
debug1: get_agent_identities: ssh_fetch_identitylist: agent contains no identities

[Et si on ajoute une clé dans l'agent ?]
% ssh-add ~/.ssh/id_ed25519
Enter passphrase for /home/stephane/.ssh/id_ed25519:
Identity added: /home/stephane/.ssh/id_ed25519 (stephane@foobar)

% ssh -vvv SERVEUR-DISTANT
…
debug1: Next authentication method: publickey
debug3: ssh_get_authentication_socket_path: path '/tmp/ssh-xrLh0tnpVwLF/agent.23934'
debug1: get_agent_identities: bound agent to hostkey
debug1: get_agent_identities: agent returned 1 keys
Autre possibilité très intéressante de l'agent (section 5), on peut faire suivre les communications sur un canal SSH (un peu comme avec X11). Cela permet, lorsque la machine A se connecte à la machine B puis à la C, d'utiliser les clés de la machine A pour s'authentifier sur la machine C. Cela utilise le mécanisme d'extension à SSH qui avait été normalisé dans le RFC 8308 pour signaler qu'on gère cette possibilité (mais comme le protocole Agent existait avant ce RFC, certains programmes n'annoncent pas cette gestion). La section 9 du RFC rappelle toutefois que cette fonction, si pratique, crée de nouveaux risques puisque elle introduit une relation de confiance transitive. Le RFC exige donc qu'elle ne soit pas activée par défaut.
Le protocole a entrainé la création de cinq nouveaux registres IANA (section 7), dont celui des types de messages (pour en ajouter un, politique « Examen par un expert », cf. RFC 8126.)
Un petit mot sur la sécurité (section 8 du RFC) puisqu'après tout, SSH est là pour améliorer notre sécurité. L'agent est chargé de garder des clés privées, il est donc très sensible et doit être de confiance. Mais le RFC rappelle aussi que l'accès à l'agent est évidemment très critique et doit être sécurisé (regardez les permissions de la prise dans l'exemple Unix plus haut), le protocole ne prévoyant aucune authentification.
Si on a accès à l'agent, et qu'il a chargé des clés, on peut
signer ce qu'on veut et donc s'authentifier auprès de serveurs
distants. Par contre, on ne peut pas récupérer de clés privées via
le protocole, qui n'a pas d'opération pour cela. Mais comme l'agent
garde les clés privées en mémoire, il faut faire attention à ce que
personne ne puisse lire cette mémoire. (La page de manuel de OpenSSH
est très nette à ce sujet et conseille d'utiliser plutôt la fonction
ProxyJump, via le -J.)
Ah, et puisque l'agent, lorsqu'il charge une clé, demande la phrase de passe de la clé, il faut aussi qu'il prenne des précautions pour limiter le risque d'une attaque par force brute (quand un attaquant essaie plein de phrases possibles). Par exemple, il peut introduire un délai après une phrase incorrecte.
Le protocole Agent est très ancien et est donc déjà mis en œuvre dans de nombreux programmes, par exemple OpenSSH (depuis 2000 !), PuTTY, Dropbear, Paramiko, la bibliothèque standard de Go, etc.
Si vous voulez afficher les messages échangés entre le client SSH
et l'agent, je ne connais pas
l'équivalent de tcpdump ou
Wireshark pour cela. Avec
OpenSSH, ssh-agent -d
affiche les connexions mais pas les messages. Sinon, on peut lire les
messages échangés avec socat (ici, un exemple
pour OpenSSH sur
Debian) :
[Dans une fenêtre]
% ssh-agent -D

[Dans une autre]
[Copier-coller la première ligne, celle qui définit SSH_AUTH_SOCK]
% mv $SSH_AUTH_SOCK /tmp/real-agent.sock
% socat -x UNIX-LISTEN:$SSH_AUTH_SOCK,fork UNIX-CONNECT:/tmp/real-agent.sock

[Dans une troisième]
[Copier-coller la première ligne, celle qui définit SSH_AUTH_SOCK]
% ssh un-serveur
Mais les messages seront bruts, sans formatage. À vous de les décoder.
Par exemple, ici,suite à un ssh-add, on voit :
> 2026/05/11 17:47:13.000145101  length=142 from=1152 to=1293
 00 00 00 8a 11 00 00 00 …
< 2026/05/11 17:47:13.000146117  length=5 from=10 to=14
 00 00 00 01 06
(Pour décoder, référez-vous au RFC, section 3, et au registre
IANA.) Le premier message (après le >) a une longueur de 138 octets (les
quatre premiers octets, 0000008A, nous le disent, socat l'affiche
mais lui ajoute les quatre octets de la longueur). Le type du
message (indiqué par l'octet suivant) est 17,
SSH_AGENTC_ADD_IDENTITY. L'agent répond (après
la <) par un message d'un seul octet, de type 6
(SSH_AGENT_SUCCESS) et de contenu nul. Si je me
connecte en SSH à un serveur, en utilisant la clé qui vient d'être
chargée, j'ai :
> 2026/05/11 17:59:54.000526321  length=5 from=665 to=669
 00 00 00 01 0b
< 2026/05/11 17:59:54.000526468  length=535 from=5 to=539
 00 00 02 13 0c 00 00 00 …
> 2026/05/11 17:59:54.000609874  length=1017 from=670 to=1686
 00 00 03 f5 0d 00 00 01 …
< 2026/05/11 17:59:54.000615719  length=285 from=540 to=824
 00 00 01 19 0e 00 00 01 14 …
Le premier message, très court, est de type 11,
SSH_AGENTC_REQUEST_IDENTITIES, il obtient une
réponse 12 (SSH_AGENT_IDENTITIES_ANSWER), puis
le client SSH demande une signature avec la clé privée que stocke
l'agent (type 13,
SSH_AGENTC_SIGN_REQUEST) et a une réponse (type
14, SSH_AGENT_SIGN_RESPONSE).
Enfin, le fichier ./PROTOCOL.agent dans le source
de OpenSSH documente les extensions d'OpenSSH
pour ce protocole agent-client.
L'article seul
RFC 9982: JSContact Version 2.0: A JSON Representation of Contact Data
Date de publication du RFC : Mai 2026
Auteur(s) du RFC : R. Stepanek (Fastmail)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF calext
Première rédaction de cet article le 28 mai 2026
Voici la version 2 du format de représentation d'entités
(personnes ou organisations) JSContact (RFC 9553). En fait, ce numéro de version est trompeur, il n'y
a qu'un seul changement, le membre uid qui
était obligatoire devient facultatif. Mais ce petit changement, qui
casse la compatibilité, oblige à changer de numéro de version.
Dans la section 2.1.9 du RFC 9553,
l'uid (User IDentifier)
était obligatoire. Alors que le vieux format
vCard (RFC 6350) le
disait facultatif, ce qui rendait difficile toute traduction
automatique de vCard vers JSContact. En outre, s'il était cool
d'avoir la garantie d'un identificateur unique pour chaque carte de
visite au format JSContact, cela ne convenait pas dans tous les
cas. Ainsi, RDAP (RFC 9083)
n'utilise pas du tout cette propriété uid.
Donc, seul changement entre les versions 1 et 2, l'attribut
uid devient optionnel. On passe de :
uid: String (mandatory)
à :
*uid: String (optional).*
Mais c'est suffisant pour obliger à changer le numéro de version de JSContact (RFC 9553, section 1.9).
Par exemple, cet object JSContact (qui n'a pas
d'uid) est désormais légal :
{
"@type": "Card",
 "version": "2.0",
 "name": {"components": [{"kind": "given","value": "Jean"},
			 {"kind": "surname","value": "Durand"}]},
           "emails": {
             "email": {
               "address": "jean.durand@example.com"
             }
          }
}
(Avec la version 1, il aurait fallu quelque chose comme
"uid": "a73c940e-b1d3-4f3c-aa50-c9749352c253"
après la version.)
L'article seul
RFC 9980: Post-Quantum Cryptography in OpenPGP
Date de publication du RFC : Juin 2026
Auteur(s) du RFC : S. Kousidis
(BSI), J. Roth, F. Strenzke (MTG
AG), A. Wussler (Proton AG)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF openpgp
Première rédaction de cet article le 1 juillet 2026
Vous le savez, le jour où des CRQC (Cryptographically Relevant Quantum Computer, un calculateur quantique capable de calculs non triviaux, contrairement aux modèles d'aujourd'hui) seront disponibles, la cryptographie sera sérieusement secouée. Il est donc important de travailler dès maintenant sur des algorithmes pour l'après-quantique, et de les intégrer dans les protocoles et les formats utilisés sur l'Internet. Ce RFC documente l'utilisation des algorithmes normalisés par le NIST dans le format OpenPGP.
Le format OpenPGP, utilisé par de nombreux logiciels de cryptographie, est normalisé dans le RFC 9580. La liste des algorithmes de chiffrement n'est pas figée et de nouveaux algorithmes peuvent être disponibles pour ce format. C'est le cas de ceux pour la cryptographie post-quantique, un sujet d'actualité. Les messages chiffrés et/ou signés au format OpenPGP peuvent avoir besoin de résister à la décryption et/ou à l'usurpation pendant de nombreuses années. Aujourd'hui, ces messages utilisent typiquement RSA ou des algorithmes à courbes elliptiques, tous étant vulnérables aux calculateurs quantiques. C'est notamment en raison de cette nécessité de sécurité sur une longue période qu'il ne faut pas attendre que les CRQC soient disponibles pour intégrer les algorithmes post-quantiques à OpenPGP. Il y a peut-être des attaquants qui stockent aujourd'hui des messages OpenPGP, en attendant d'avoir un CRQC pour les lire (ou pour imiter des signatures).
(Rappelons au passage qu'OpenPGP n'est pas utilisé que dans le courrier électronique. Il sert, par exemple, à authentifier le code avec git, ou les paquetages compilés, avec apt et rpm.)
Il ne suffit pas d'ajouter les nouveaux algorithmes aux registres IANA. Il y a des problèmes spécifiques, comme les clés hybrides (une PQ et une classique) et composées (hybrides, mais présentées d'une manière unifiée). En effet, il ne servirait à rien de déployer des algorithmes post-quantiques si ceux-ci étaient cassables par de la cryptanalyse classique. Rien ne dit que ces « nouveaux » algorithmes soient incassables. Et comme ils sont relativement récents, on ne peut pas avoir le même degré de confiance qu'avec RSA ou ECDSA. L'approche la plus courante aujourd'hui, et que ce RFC suit, est d'utiliser une technique hybride : combinaison d'un algorithme traditionnel et d'un algorithme post-quantique. On n'abandonne donc pas RSA ou ECDSA, on les flanque d'un collègue, ce qu'on appelle le PQ/T (post-quantique/traditionnel, cf. section 1.1.1).
Plus précisément, notre RFC utilise des composés, des hybrides PQ/T mais où les deux clés, la post-quantique et la traditionnelle, sont gérées comme une seule. Le RFC 9794 est la bonne lecture, si vous voulez approfondir ces notions d'hybride et de composé et vous avez aussi intérêt à lire le RFC 9958, « Post-Quantum Cryptography for Engineers ».
Quels sont ces nouveaux algorithmes ? La section 1.2 les résume :
- ML-KEM, normalisé dans la norme FIPS-203, pour l'échange de clés préalable au chiffrement,
- ML-DSA, normalisé dans FIPS-204, pour la signature,
- SLH-DSA, normalisé dans FIPS-205, également pour la signature.
Notez que l'algorithme SLH-DSA, lui, est considéré suffisamment sûr pour se passer de l'assistance d'un algorithme traditionnel (il utilise des problèmes mathématiques complètement différents de ceux utilisés par ML-KEM ou ML-DSA). Les deux autres vont être utilisés par OpenPGP avec de la cryptographie traditionnelle, en l'occurrence ECDH avec les courbes X25519 et X448 (RFC 7748) et EdDSA (RFC 8032). Pour la vérification d'une signature, les deux (post-quantique et traditionnelle) signatures doivent être valides (cf. sections 3 et 5.2.3). Pour le chiffrement, les deux clés obtenues doivent être utilisées.
Le format OpenPGP permet d'avoir plusieurs signatures dans un message mais ces signatures parallèles sont différentes des clés composées utilisées pour le PQ/T car le succès d'une seule signature suffit à la validation. (Idem pour le chiffrement, cf. section 3.) Évidemment, le système n'est résistant aux CRQC que si toutes les signatures utilisent un algorithme PQ ou PQ/T. Si ces signatures multiples, incluant au moins une clé T (traditionnelle, sans post-quantique) sont moins sûres, elles ont par contre l'avantage d'assurer la compatibilité avec les vieilles versions des logiciels OpenPGP (section 5.2.5 du RFC 9580).
La section 2 du RFC donne la liste exhaustive des algorithmes qui viennent d'être officiellement ajoutés. À partir des trois cités plus haut, il y a quelques variantes, fondées sur la taille de certains paramètres ou sur la courbe elliptique utilisée dans le composé. Ainsi, SLH-DSA a trois variantes, SLH-DSA-SHAKE-128f (f pour fast car il optimise la vitesse), SLH-DSA-SHAKE-128s (s pour short car il optimise la taille) et SLH-DSA-SHAKE-256s. ML-KEM a deux variantes, ML-KEM-768+X25519 et ML-KEM-1024+X448, avec des courbes différentes.
Notez enfin que les clés PQ/T ne doivent être utilisées qu'avec des données OpenPGP des versions 4 ou 6 (et même uniquement version 6 pour ML-KEM-1024+X448 et ML-DSA). Ici, par exemple, GnuPG montre un paquet OpenPGP de version 3, trop vieux pour gérer le post-quantique :
% gpg --list-packets review.txt.gpg
…
:pubkey enc packet: version 3, algo 1, keyid XXXXXXXXX
	data: [4096 bits]
Les sections 4, 5 et 6 du RFC expliquent en détail le format des nouvelles clés et comment les utiliser. La section 7 donne des conseils sur les algorithmes de cryptographie symétrique, par exemple qu'il est nécessaire de mettre en œuvre AES-256 (la version à 128 bits est possiblement cassable grâce à l'algorithme de Grover).
Et la migration depuis les anciens algorithmes ? Tous les logiciels qui mettent en œuvre OpenPGP ne vont pas passer au post-quantique en même temps. On aura des messages qui vont passer d'un logiciel récent à un ancien, qui ne pourra pas les lire. La section 8 ajoute des conseils pour bien réussir sa migration. Déjà, un logiciel récent, qui pense que les récepteurs de ses messages seront pré-quantiques peut chiffrer ses messages avec une clé PQ (ou PQ/T) et une clé traditionnelle (chiffrement en parallèle, où une seule clé est nécessaire, et pas en série, comme c'est le cas ave les solutions hybrides citées plus haut, où les deux clés sont nécessaires). Bien sûr, s'il fait cela, le message sera déchiffrable par un calculateur quantique. Il faut donc choisir entre sécurité et interopérabilité (avec les vieux logiciels). PGP étant conçu pour des communications asynchrones (comme le courrier électronique), il n'est pas possible de savoir à l'avance les capacités du récepteur.
Le même problème se pose pour les signatures. Lors d'une vérification de signature, n'importe laquelle des deux signatures sera acceptée (là encore, on parle de signatures séparées, qui ont toujours existé dans OpenPGP, pas des hybrides du PQ/T). Le RFC permet toutefois à un vérificateur paranoïaque, ou simplement un vérificateur qui sait que l'émetteur a une clé PQ ou PQ/T, d'ignorer les signatures traditionnelles.
Enfin, la section 9 du RFC discute un certain nombre de questions de sécurité. Par exemple, elle explique comment les signatures composites du PQ/T ne sont pas vulnérables aux attaques par suppression d'une des signatures (les métadonnées indiquent l'identificateur de l'algorithme hybride).
Quelles sont les mises en œuvre de ces nouveaux algorithmes ? Malheureusement, il semble que GnuPG ne suive pas les récents RFC sur le format OpenPGP (sur cette affaire, lire le point de vue de Debian ou celui d'Arch Linux), entre autre (mais pas uniquement) sur le post-quantique. On va donc tester avec les autres (il existe une liste).
Si vous voulez écrire votre propre programme OpenPGP (ce que je ne conseillerai pas : la cryptographie, c'est difficile, et les bogues ne se voient pas forcément), l'annexe A du RFC, qui fait la grande majorité du RFC, est composée de vecteurs de test.
Les programmes testés sont conformes au
projet de standard SOP et ont donc à
peu près la même interface utilisateur (actuellement en projet, dans
draft-dkg-openpgp-stateless-cli). Souvent, le post-quantique
n'est pas encore intégré dans les versions officielles et il va
falloir changer de branche et compiler.
Commençons avec rsop, écrit en
Rust. Après le
cargo install pgp :
% rsop list-profiles  generate-key
default: v4 key using Curve25519 (alias: draft-koch-eddsa-for-openpgp-00)
compatibility: v4 key using RSA (alias: rfc4880)
performance: v6 key using Ed25519/X25519 (alias: rfc9580)
security: v6 key using Ed448/X448 (alias: rfc9580-curve448)
Je vous l'avais bien dit : pas de post-quantique. Mais la FAQ dans le code nous le dit « ### Is rPGP adding support for Post Quantum Cryptography (PQC)? Yes, rPGP implements the IETF draft [Post-Quantum Cryptography in OpenPGP](https://datatracker.ietf.org/doc/draft-ietf-openpgp-pqc/), gated behind the feature `draft-pqc`. ». Ah, c'est planqué dans une feature. Compilons :
% cargo install --features draft-pqc rsop

% rsop list-profiles  generate-key
default: v4 key using Curve25519 (alias: draft-koch-eddsa-for-openpgp-00)
compatibility: v4 key using RSA (alias: rfc4880)
performance: v6 key using Ed25519/X25519 (alias: rfc9580)
security: v6 key using Ed448/X448 (alias: rfc9580-curve448)
draft-ietf-openpgp-pqc-14-v4-ed25519-mlkem768x25519: TESTING ONLY
draft-ietf-openpgp-pqc-14-v6-ed25519-mlkem768x25519: TESTING ONLY
draft-ietf-openpgp-pqc-14-v6-mldsa65ed25519-mlkem768x25519: TESTING ONLY
draft-ietf-openpgp-pqc-14-v6-mldsa87ed448-mlkem1024x448: TESTING ONLY
draft-ietf-openpgp-pqc-14-v6-slhdsashake128s-mlkem768x25519: TESTING ONLY
draft-ietf-openpgp-pqc-14-v6-slhdsashake128f-mlkem768x25519: TESTING ONLY
draft-ietf-openpgp-pqc-14-v6-slhdsashake256s-mlkem1024x448: TESTING ONLY
Ça marche, on a du post-quantique, utilisons-le :
% rsop generate-key --profile draft-ietf-openpgp-pqc-14-v6-ed25519-mlkem768x25519 > key.asc
OK, on a une clé hybride (ML-KEM et Ed25519). Créeons la clé publique :
% cat key.asc | rsop extract-cert > cert.asc
Et maintenant, on peut chiffrer un fichier avec la clé publique :
% cat hello.txt | rsop encrypt cert.asc > hello.asc
Et le déchiffrer avec la clé privée :
% cat hello.asc | rsop decrypt key.asc
Hello, world
Bon, on a tout fait avec le même programme, mais le but d'OpenPGP est l'interopérabilité. Essayons avec un deuxième programme, Sequoia, pour lequel il y a des instructions détaillées pour le compiler avec gestion du post-quantique :
% sudo apt install libsqlite3-dev
% git clone https://gitlab.com/sequoia-pgp/sequoia-sq.git
% git checkout pqc
% cargo build --release --locked --no-default-features --features crypto-openssl
Et utilisons-le pour regarder les fichiers produits par rsop :
% sq  inspect key.asc
key.asc: Transferable Secret Key.

      Fingerprint: AC7FD6CBD09E90C928C2ED5796A69001B5F0535CE6BF09C227DFE71063006BD0
  Public-key algo: Ed25519
  Public-key size: 256 bits
       Secret key: Unencrypted
    Creation time: 2026-02-09 17:36:25 UTC
        Key flags: certification, signing

           Subkey: 91BED065B7E654656D3354CA16E901D8F8B192874385EB6C325421055AFB5B9E
  Public-key algo: ML-KEM-768+X25519
       Secret key: Unencrypted
    Creation time: 2026-02-09 17:36:25 UTC
        Key flags: transport encryption, data-at-rest encryption
Joli, non ? rsop avait bien fabriqué une clé hybride et sq arrive à la lire.
% cat hello.asc | sq  decrypt --recipient-file key.asc
Encrypted and protected using AES-256/OCB
Hello, world
Decrypted by AC7FD6CBD09E90C928C2ED5796A69001B5F0535CE6BF09C227DFE71063006BD0, unknown
0 authenticated signatures.
Et Sequoia peut déchiffrer les messages chiffrés par rsop.
% sq inspect --cert-file cert.asc < hello.asc
OpenPGP Certificate.

      Fingerprint: AC7FD6CBD09E90C928C2ED5796A69001B5F0535CE6BF09C227DFE71063006BD0
  Public-key algo: Ed25519
  Public-key size: 256 bits
    Creation time: 2026-02-09 17:36:25 UTC
        Key flags: certification, signing

           Subkey: 91BED065B7E654656D3354CA16E901D8F8B192874385EB6C325421055AFB5B9E
  Public-key algo: ML-KEM-768+X25519
    Creation time: 2026-02-09 17:36:25 UTC
        Key flags: transport encryption, data-at-rest encryption
Et examiner ses clés. rsop et sq étaient tous les deux écrits en Rust donc testons l'interopérabilité avec un programme en Go :
% git clone https://github.com/ProtonMail/gosop.git
% cd gosop
% git checkout gosop-gopenpgp-v3-pqc
% go build

% ./gosop list-profiles generate-key
default: Generate v4 keys using Curve25519
compatibility: Generate v4 keys using 3072-bit RSA (alias: rfc4880)
performance: Generate v6 keys using Ed25519/X25519 (alias: rfc9580)
security: Generate v6 keys using Ed448/X448
draft-ietf-openpgp-pqc-09: ML-KEM-768 and ML-DSA-65
draft-ietf-openpgp-pqc-09-high-security: ML-KEM-1024 and ML-DSA-87
draft-ietf-openpgp-persistent-symmetric-keys-00: AEAD and HMAC

% ./gosop/gosop decrypt key.asc < hello.asc
Hello, world
Et tout se passe bien.
L'article seul
RFC 9975: Clarifications on CDS/CDNSKEY and CSYNC Consistency
Date de publication du RFC : Mai 2026
Auteur(s) du RFC : P. Thomassen (SSE - Secure Systems
Engineering)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF dnsop
Première rédaction de cet article le 28 mai 2026
Pour compléter un processus de sécurisation des noms de domaine avec DNSSEC, il faut transmettre au domaine parent votre clé publique. Le faire manuellement via l'interface Web du BE n'est pas pratique donc il existe un moyen d'automatiser cela, les CDS/CDNSKEY, moyen décrit dans le RFC 7344. Mais attention à la sécurité ! Ce moyen n'est sûr que si on suit quelques précautions, décrites dans ce nouveau RFC.
Bon, je sais, j'ai simplifié, on ne transmet pas forcément au domaine parent sa clé publique mais parfois un condensat de celle-ci. (Le domaine parent publiera ensuite un enregistrement DS, contenant un condensat que vous aurez donné ou bien qu'il aura calculé à partir de la clé.) Ça ne change pas grand'chose en pratique. Le RFC 7344 décrit comment automatiser le changement de clé en publiant dans son domaine des enregistrements CDS et/ou CDNSKEY, qui informent le parent. (Et le RFC 9615 permet de le faire pour la configuration initiale, pas juste pour un changement.) Avec une technique proche, les enregistrements CSYNC du RFC 7477, on peut aussi automatiser le changement des serveurs de noms faisant autorité.
À partir de là, le gestionnaire du domaine parent (typiquement un registre de noms de domaine) va récupérer ces enregistrements et agir (modifier les enregistrements DS et NS dans son domaine). La façon la plus simple de récupérer les CDS, CDNSKEY et CSYNC est de faire une bête requête DNS classique, donc via son résolveur par défaut :
% dig turris.cz CDS
…
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 16850
;; flags: qr rd ra ad; QUERY: 1, ANSWER: 1, AUTHORITY: 0, ADDITIONAL: 1
…
;; ANSWER SECTION:
turris.cz.		5	IN	CDS	53148 13 2 9A0E997A2992D4089CE39C1976DC65C00C9D20A6C36187F897E71D6E 23368E6E

;; Query time: 24 msec
;; SERVER: 192.168.2.254#53(192.168.2.254) (UDP)
;; WHEN: Fri Jan 09 11:15:20 CET 2026
;; MSG SIZE  rcvd: 86

% dig alatienne.fr CDNSKEY
…
;; ->>HEADER<<- opcode: QUERY, status: NOERROR, id: 53877
;; flags: qr rd ra ad; QUERY: 1, ANSWER: 1, AUTHORITY: 0, ADDITIONAL: 1
…
;; ANSWER SECTION:
alatienne.fr.		3600 IN	CDNSKEY	257 3 13 (
				mdsswUyr3DPW132mOi8V9xESWE8jTo0dxCjjnopKl+Gq
				JxpVXckHAeF+KkxLbxILfDLUT0rAK9iUzy1L53eKGQ==
				) ; KSK; alg = ECDSAP256SHA256 ; key id = 2371

;; Query time: 52 msec
;; SERVER: 127.0.0.1#53(127.0.0.1) (UDP)
;; WHEN: Thu Feb 05 16:35:32 CET 2026
;; MSG SIZE  rcvd: 229
Mais cette méthode n'est pas très sûre et nous allons voir pourquoi, et comment arranger les choses.
Ici, la réponse CDS était signée par DNSSEC (le
flag ad, pour
Authentic Data). Mais ce n'est pas toujours le
cas (avec les CSYNC, ou tout simplement lors de la configuration
initiale de DNSSEC, cf. RFC 8078). Le fond du
problème est que les serveurs faisant
autorité pour le domaine qui publie CDS, CDNSKEY ou CSYNC
peuvent être en désaccord. (Ou bien, mais le RFC ne semble pas le
mentionner, il y a eu empoisonnement de la mémoire du résolveur.) Ce
désaccord peut être dû à un piratage d'un des serveurs (ou à une
malveillance de ses opérateurs) mais il peut être aussi le résultat
d'un cafouillage technique
(un serveur ne se synchronisant plus) ou organisationnel, les
serveurs n'étant pas forcément gérés par la même entité. Sans
compter le risque d'une délégation boiteuse (lame
delegation) où un des serveurs listés dans l'ensemble NS
n'est pas censé être serveur pour ce domaine. D'ailleurs, même
DNSSEC ne protège pas dans tous les cas, s'il y a plusieurs signeurs
(RFC 8901), ils peuvent aussi déconner
séparement. Avec le comportement par défaut du résolveur typique
(accepter la réponse du premier serveur faisant autorité qui
répond), un seul des serveurs faisant autorité peut déclencher un
changement de configuration dans le domaine parent. Le cœur de notre
nouveau RFC est
de dire que le logiciel qui récupère CDS/CDNSKEY/CSYNC doit
s'assurer que les serveurs faisant autorité sont
cohérents, qu'ils renvoient tous la même
réponse.
Cela ne peut pas se faire via un résolveur typique, je n'en connais pas qu'on puisse configurer pour faire cela, il faut donc interroger directement les serveurs faisant autorité. Par exemple, pour la requête dig ci-dessus, un moyen de le faire serait, par exemple en shell :
% for ns in $(dig +short turris.cz NS); do
  dig @$ns +short turris.cz CDS
done
53148 13 2 9A0E997A2992D4089CE39C1976DC65C00C9D20A6C36187F897E71D6E 23368E6E
53148 13 2 9A0E997A2992D4089CE39C1976DC65C00C9D20A6C36187F897E71D6E 23368E6E
53148 13 2 9A0E997A2992D4089CE39C1976DC65C00C9D20A6C36187F897E71D6E 23368E6E
Et il faudrait ensuite s'assurer que toutes les réponses sont identiques. Sinon, le domaine parent s'abstient d'agir. (Comme les lecteurs et lectrices de ce blog sont très fort·es en réseau, ielles ont certainement remarqué que j'avais simplifié : comme un serveur peut avoir plusieurs adresses IP, il faudrait les tester toutes. Des exemples de programmes plus perfectionnés figurent par la suite.)
Ces nouvelles règles amènent à mettre à jour quelques RFC, qui ne les spécifiaient pas : les RFC 7344 et la section 3.1 du RFC 7477, qui conseillait de ne demander qu'à un seul serveur faisant autorité (ce que fait le résolveur typique mais qui n'est pas assez sûr).
La section 3 du RFC liste plus formellement les nouvelles exigences :
- Tester la présence et le contenu des CDS/CDNSKEY/CSYNC via toutes les adresses IP des serveurs faisant autorité.
- Toutes les réponses doivent être identiques.
- On peut arrêter le test dès qu'au moins une des réponses correspond au DS/NS existant. Cela veut dire qu'au moins un des serveurs faisant autorité ne veut pas qu'on change.
Si et seulement si toutes les réponses sont identiques, et différentes de la situation actuelle, le gestionnaire du domaine parent peut envisager de modifier NS et DS.
Notez que, si les serveurs faisant autorité utilisent l'anycast, le test ne sera pas complet, le vérificateur de cohérence ne testera qu'une seule instance d'un nuage anycast. Dans ce cas, il peut être intéressant de tester la cohérence depuis plusieurs points de mesure, pour avoir des chances de contacter plusieurs instances anycast.
La même règle s'applique aux enregistrements CSYNC du RFC 7477. La section 3.2 de notre RFC détaille comment traiter ces enregistrements, qui permettent notamment de synchroniser les enregistrements NS du domaine parent (et la colle) avec ceux du domaine fils. Il y a une petite nuance pour le numéro de série de la zone que contient l'enregistrement CSYNC (il doit être identique à celui du SOA du même serveur, pas forcément à ceux des CSYNC des autres serveurs faisant autorité).
La section 5 de notre RFC discute les conséquences pour la sécurité. Si on ne fait pas les vérifications décrites ici, il y a un risque de copier dans la zone parente des données incorrectes, voire créées par un attaquant, par exemple parce qu'il a réussi à pirater un des serveurs faisant autorité ou bien parce qu'il gérait un de ces serveurs mais agissant sans autorisation du gérant de la zone (cas courant si on sous-traite certains de ses serveurs secondaires). Ce RFC privilégie donc l'intégrité des données, au risque, on peut le remarquer, qu'un changement souhaité prenne davantage de temps, si un des serveurs faisant autorité a des problèmes. Que faire si un de ces serveurs ne veut vraiment pas jouer le jeu et, par exemple, ne se synchronise plus et ne publie pas le nouveau CDS/CDNSKEY/CSYNC ? La section 5 dit qu'il faut donc maintenir un canal traditionnel (via le BE, par exemple), pour pouvoir changer quand même les données publiées par la zone parente. C'est par exemple le rôle d'EPP (RFC 5730).
Cette vérification de la cohérence a déjà été mise en œuvre dans les logiciels de TANGO et CORE, ainsi que déployée par le registre suisse. Zonemaster fait ce test.
Enfin, l'annexe A du RFC décrit plus en détail des scénarios où l'incohérence entre les serveurs faisant autorité pour un domaine a eu des conséquences fâcheuses. Par exemple, si un domaine a une délégation boiteuse, vers un serveur qui n'existe pas, un malveillant peut créer le serveur en question, mettre un CSYNC en indiquant uniquement des serveurs qu'il contrôle et transformer une simple délégation boiteuse en un détournement complet du nom. Si le serveur non existant était dans un nom de domaine non enregistré, l'attaquant n'a qu'à enregistrer ce nom (attaque flamant). Si le serveur non existant était sur une adresse IP libre chez un hébergeur public, l'attaquant n'a qu'à créer des machines chez cet hébergeur jusqu'à tomber sur l'adresse en question (une variante de l'attaque des sous-domaines). Ce genre d'attaques est décrit dans des articles comme « Unresolved Issues: Prevalence, Persistence, and Perils of Lame Delegations » ou « Risky BIZness: risks derived from registrar name management ». Bon, si le domaine est signé avec DNSSEC, il est protégé, non ? Oui, sauf si l'attaquant peut changer la clé avec un CDS… D'où l'importance de la vérification de cohérence de ce RFC.
Autre exemple d'accident possible (et qui n'est pas dû à une attaque délibérée), dans le cas où un domaine a plusieurs signeurs DNSSEC (RFC 8901), si un des serveurs faisant autorité ne publie que ses propres clés dans un CDS. Sans vérification de cohérence, au lieu d'avoir plusieurs DS comme prévu, on n'en aura qu'une partie.
Et si vous cherchez un programme simple qui fait à peu près ce
que demande le RFC, vous avez cds-consistency.py
% ./cds-consistency.py knot-resolver.cz
knot-resolver.cz is consistent, data is "None"

% ./cds-consistency.py àlacon.fr
àlacon.fr is consistent, data is "7177 13 2 fa99827c7aca1681b8905285e7fa33ec5adccb430393b4fa1e9f9aa3d9263709"
L'article seul
RFC 9973: TLS 1.3 Extension for Using Certificates with an External Pre-Shared Key
Date de publication du RFC : Juillet 2026
Auteur(s) du RFC : R. Housley (Vigil Security)
Chemin des normes
Première rédaction de cet article le 16 juillet 2026
L'authentification dans TLS se fait typiquement soit à partir d'un certificat, soit par une clé partagée à l'avance. Ce RFC spécifie une extension de TLS qui permet d'utiliser certificat et clé partagée à l'avance. Il remplace le RFC 8773 mais ne change pas grand'chose, la principale modification étant que ce nouveau RFC a le statut de norme (au lieu d'être considéré comme expérimental).
Rappelons d'abord qu'il y a deux sortes de clés partagées à l'avance (PSK, pour Pre-Shared Key) : celles qui ont été négociées dans une session précédente (resumption PSK) et celles qui ont été négociées par un mécanisme extérieur (envoi par pigeon voyageur sécurisé…), les external PSK. Ce RFC ne concerne que les secondes. Les certificats et les clés partagées à l'avance ont des avantages et des inconvénients. Les certificats ne nécessitent pas d'arrangement préalable entre client et serveur, ce qui est pratique. Mais il faut se procurer un certificat auprès d'une AC. Et les certificats, comme ils reposent sur des algorithmes comme RSA ou ECDSA, sont vulnérables aux progrès de la cryptanalyse, par exemple en utilisant un (futur) ordinateur quantique (enfin, un CRQC, un Cryptographically Relevant Quantum Computer). Utiliser une clé partagée à l'avance n'est pas forcément commode (par exemple quand on veut la changer) mais cela peut être plus sûr. Or, la norme TLS (RFC 9846) ne permettait d'utiliser qu'une seule des deux méthodes d'authentification. Si on les combinait ? L'ajout d'une clé externe permettrait de rendre la sécurité plus solide.
Le principe est simple : notre RFC spécifie une extension à TLS,
tls_cert_with_extern_psk (valeur
33). Le client TLS l'envoie dans son
ClientHello. Elle indique la volonté de
combiner certificat et PSK. Elle est accompagnée d'extensions
indiquant quelle est la clé partagée à utiliser. Si le serveur TLS
est d'accord, il met l'extension
tls_cert_with_extern_psk dans son message
ServerHello. (Le serveur ne peut pas décider
seul de l'utilisation de cette extension, il faut que le client ait
demandé d'abord.)
Les clés ont une identité, une série d'octets sur lesquels client
et serveur se sont mis d'accord avant (PSK = Pre-Shared
Key, clé partagée à l'avance). C'est cette identité qui
est envoyée dans l'extension pre_shared_key,
qui accompagne tls_cert_with_extern_psk. La clé
elle-même est bien sûr un secret, connu seulement du client et du
serveur (et bien protégée : ne la mettez pas sur un fichier lisible
par tous). Voyez la section 7 du RFC pour une discussion plus
détaillée de la gestion de la PSK.
Une fois que client et serveur sont d'accord pour utiliser l'extension, et ont bien une clé en commun, l'authentification se fait via le certificat (sections 4.4.2 et 4.4.3 du RFC 9846) et on utilise ensuite, non pas seulement la clé générée (typiquement par Diffie-Hellman), mais la combinaison de la clé générée et de la PSK. L'entropie de la PSK s'ajoute donc à celle de la clé générée de manière traditionnelle.
Du point de vue de la sécurité, on note donc que cette technique de la PSK est un strict ajout à la sécurité actuelle, donc on peut garantir que son utilisation ne diminuera pas la sécurité.
L'annexe A du RFC liste les changements depuis l'ancien RFC 8773 :
- Le principal est le changement de statut, d'Expérimental à Norme. La technique spécifiée dans ce RFC est désormais considérée comme stable et validée.
- La menace des calculateurs quantiques est un peu relativisée. (Elle ne semble pas se rapprocher.)
- Autre relativisation, le RFC insiste désormais sur le fait que la PSK ne va pas servir à l'authentification (mon article sur le RFC 8773 était confus sur ce point).
- Une erreur a été corrigée (mélange entre client et serveur).
- Le terme de master secret a été remplacé par le plus gentillet main secret.
L'article seul
RFC 9969: IAB AI-CONTROL Workshop Report
Date de publication du RFC : Mai 2026
Auteur(s) du RFC : M. Nottingham, S. Krishnan
Pour information
Première rédaction de cet article le 20 mai 2026
Ah, l'IA… Vaste sujet, et d'actualité. Une des questions qui reviennent souvent est celle de l'utilisation du contenu qu'on trouve sur le Web pour entrainer les grands modèles, sa légitimité, la charge qu'elle induit pour les serveurs, les moyens de la contrôler, etc. Un colloque avait été organisé par l'IAB en septembre 2024 sur ces questions et ce RFC en est le compte-rendu. Ce colloque avait lancé le projet IETF aipref.
Une petite précision politique d'abord : le RFC précise bien qu'il s'agit d'un compte-rendu et que l'IAB n'approuve pas forcément tout ce qui a été dit à ce colloque (section 1.2 du RFC). Je rajoute que j'ai aussi des opinions sur le sujet, donc je mettrais [entre crochets] ce qui est mon opinion, et ne vient pas du RFC. Le reste n'est donc pas de moi, j'en rends compte, c'est tout, ne me tapez pas.
Ce colloque fait partie de la série de colloques qu'organise régulièrement l'IAB pour explorer des tendances à plus ou moins long terme, sans les obligations de l'IETF de produire normes et documents.
Donc, les LLM (qui ne sont qu'une partie des techniques qu'on regroupe sous le terme marketing d'« IA ») fonctionnent en deux phases : on entraine le modèle en lui faisant ingérer une grande quantité de contenu (textes, images ou autres), puis il va pouvoir inférer du contenu à partir de ce qu'il a digéré pendant la phase d'entrainement, et d'une demande (dite prompt). Le contenu inféré n'est jamais tout à fait identique à celui utilisé pour l'entrainement (autrement, cela serait du plagiat, potentiellement illégal). Les LLM ne marchant bien, à l'heure actuelle, que si le corpus d'entrainement était énorme, ils sont très gourmands en données et une source évidente de contenu en grande quantité est le Web. Des bots ou crawlers parcourent donc le Web, ramassant du contenu. Voici par exemple un extrait du journal du serveur qui héberge ce blog, montrant le bot de Perplexity récoltant du contenu :
18.210.92.235:64884 - - [09/Jan/2026:07:26:15 +0000] "GET /images/TCP_state_diagram.jpg HTTP/1.1" 200 96551 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)" www.bortzmeyer.org TLS
18.97.9.103:64398 - - [09/Jan/2026:08:31:39 +0000] "GET /bitcoin-metamorphoses.html HTTP/1.1" 200 8982 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)" www.bortzmeyer.org TLS
18.97.9.101:57493 - - [09/Jan/2026:08:31:39 +0000] "GET /robots.txt HTTP/1.1" 404 3250 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)" www.bortzmeyer.org TLS
18.97.9.103:48122 - - [09/Jan/2026:08:47:36 +0000] "GET /nist-pq.pdf HTTP/1.1" 200 84543 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)" www.bortzmeyer.org TLS
18.97.9.96:25157 - - [09/Jan/2026:08:51:37 +0000] "GET /files/capitole-libre-2019-quic-pour-impression.pdf HTTP/1.1" 200 212507 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)" www.bortzmeyer.org TLS
Une des questions soulevées par cette récolte de données est qu'elle n'était pas prévue à l'origine. Certains webmestres qui mettent du contenu en ligne estiment donc qu'un nouvel usage (l'entrainement des LLM) justifie de nouvelles règles et de nouvelles possibilités de contrôle par le serveur Web. C'est par exemple ce que prévoit l'AI Act européen.
Le colloque (ou atelier) de l'IAB s'est tenu les 19 et 20 septembre 2024 (oui, le RFC met trop longtemps à sortir) et prévoyait de travailler sur tous les aspects liés à cette récolte de données (cf. l'appel à participation). Le colloque regroupait des personnes de divers horizons, experts techniques, entreprises d'IA, fournisseurs de contenu, décideurs politiques, etc. La liste figure dans l'annexe A.2. La règle suivie était celle de Chatham House (tout ce qui se dit est public mais sans le lier à un·e participant·e particulier·ère). D'ailleurs, le RFC note qu'au moins un participant n'a pas voulu que son identité soit dévoilée, juste qu'il était un représentant officiel d'un gouvernement. Et, comme déjà dit, le RFC rend compte des discussions, cela ne signifie pas que l'IAB approuve tout ce qui a été dit.
La section 2 du RFC résume les discussions (la totalité des
soumissions sont en
ligne). Aujourd'hui, les fournisseurs de contenu, les
webmestres, peuvent exprimer leurs choix quant à la récolte de
données par divers moyens. Il y a par exemple une solution technique
existante, c'est le
robots.txt, qui est
décrit dans le RFC 9309. Notez que, en
l'absence du fichier robots.txt, les
bots peuvent tout récolter. C'est donc une
solution opt-out. Il y a
aussi des solutions non techniques par exemple les
conditions d'utilisation (ainsi, ce blog est sous licence GFDL et les contenus peuvent
donc être réutilisés, à la condition que les destinataires jouissent
des mêmes droits de réutilisation). [Tiens, par contre, il n'existe pas
de licence
CC-BY-NoAI ?] Pour revenir à la technique, les webmestres
peuvent aussi bloquer les crawlers par leur
adresse IP, ou leur User-Agent (RFC 9110, section 10.1.5), ou carrément tout mettre derrière
un paywall.
Comme indiqué plus haut, ces solutions sont en général opt-out, donc par défaut, la récolte est autorisée. (Sur ce blog, et c'est apparemment le cas de la plupart des serveurs HTTP, plus de la moitié des requêtes sont faites par des bots, mais pas forcément liés à l'IA, c'était déjà le cas avant les LLM.) On constate (cf. l'exposé « Consent in Crisis: The Rapid Decline of the AI Data Commons ») une tendance à la fermeture : la récolte devient de plus en plus difficile car de nombreux serveurs bloquent les accès qu'ils pensent dûs à un bot. Le Web tend donc à se fermer.
[Le RFC n'est pas clair sur ce point mais, pour moi, il est important de faire la différence entre les problèmes techniques et opérationnels posés par certains bots qui, qu'ils travaillent pour l'IA ou pas, « matraquent » avec excès les serveurs, et les problèmes politiques et financiers liés à l'utilisation qui est faite des données récoltées. Les problèmes techniques et opérationnels causés par des « bots fous » existaient bien avant les LLM. Par contre, les problèmes politiques (légitimité à réutiliser le contenu) et financiers (perte de revenus pour les ayant droits, comme mentionné dans le RFC) sont plus spécifiques de l'IA. Le RFC ne parle pas vraiment des problèmes opérationnels posés par l'agressivité de certains bots - pas forcément liés à l'IA, d'ailleurs - mais la réunion IETF 123 à Madrid avait vu de très intéressants exposés à ce sujet.]
À l'heure actuelle, il est difficile de savoir ce qui est permis,
au delà des simples consignes du
robots.txt. Les gérants des serveurs n'ont pas
de moyen standard et automatiquement analysable de faire connaitre
leurs conditions d'utilisation, et les bots n'ont
donc pas non plus de moyen de savoir ce qui est permis. [Il va de
soi qu'il y a des bots qui, de toute façon, s'en
foutent. Le travail de normalisation à l'IETF ne pourra concerner que les
bots honnêtes et ne dispensera pas de mesures de
sécurité contre les malhonnêtes.]
Le RFC creuse certain aspects de la question. Par exemple, en
section 2.1, le problème de la différence entre le moment du
ramassage des données et celui de leur utilisation. Les consignes du
serveur (comme le robots.txt) sont lues au
moment du ramassage mais certains responsables de contenu voudraient
exprimer des choix concernant l'utilisation, or celle-ci se fait à
un autre moment, décorrélé du premier. Certaines récoltes, comme
celle faite par Common Crawl, peuvent servir
à de multiples usages et des consignes concernant le ramassage ne
sont donc pas appropriées. Autre exemple que Common Crawl, on peut
avoir une organisation qui gère un moteur de recherche du
Web et développe un LLM, et qui
utilise le même crawler pour les deux
usages. Certains webmestres estiment que la première utilisation ne
pose pas de problème (au bout du compte, cela ramènera du trafic sur
leur site Web) mais s'opposent à la seconde car elle n'apportera pas
de trafic, le LLM donnant des réponses qui suffiront à
l'utilisateur.
Du point de vue technique, il faut aussi noter que le principe d'entrainement d'un LLM fait qu'on utilise toutes les données et, qu'une fois le modèle créé, il n'y a pas d'étiquetage spécifique de la source de telle ou telle réponse du LLM. (C'est pour cela que les LLM ont du mal à indiquer leurs sources.) Un webmestre qui souhaiterait dire « d'accord pour servir à l'entrainement des IA mais pas pour que ces IA aient un usage militaire, ou bien pas un usage commercial » ne le peut pas, en raison de cette limite technique. Et même si ce moyen existait, le gérant du LLM serat obligé de faire N modèles, pour toutes les permutations des différents critères (ou tout simplement d'exclure tous les contenus ayant une licence restrictive, ce qui limiterait la représentativité du corpus d'entrainement du modèle).
Enfin, les préférences changent dans le temps et celles exprimées au moment de la récolte des données peuvent ne pas être à jour lorsque les données seront utilisées pour l'entrainement d'un LLM.
Le problème est déjà compliqué si on suppose que tous les acteurs sont de bonne foi et respectent les règles. Mais, évidemment, la confiance ne règne pas, et pour de bonnes raisons. [Les entreprises capitalistes trichent, que ce soit celles qui entrainent les LLM ou bien celles des ayant droits.] Il n'y a pas de moyen facile de vérifier le respect des préférences exprimées par les gérants du contenu. Et c'est d'autant plus inquiétant que les entreprises de l'IA n'ont pas vraiment de motivation pour respecter les règles : aucun risque de sanction [surtout compte-tenu des déclarations de Trump contre tout projet de régulation de l'IA]. Cette absence de confiance entraine l'utilisation importante de moyens techniques de blocage, comme de bloquer les adresses IP des bots connus. Il y a même un bot qui suggère cette solution :
119.28.89.249:58834 - - [21/Jan/2026:15:32:02 +0000] "GET /5153.xml HTTP/1.1" 200 6891 "-" "Mozilla/5.0 (compatible; Thinkbot/0.5.8; +In_the_test_phase,_if_the_Thinkbot_brings_you_trouble,_please_block_its_IP_address._Thank_you.)" www.bortzmeyer.org TLS
L'atelier de l'IAB a passé du temps sur la question de
l'attachement des préférences au contenu (section 2.3). Le
robots.txt (RFC 9309) est
très bien, très déployé et largement reconnu. Mais il manque de
souplesse pour les gros sites qui souhaitent un système plus
granulaire. Par exemple, si un site de vidéos souhaitait restreindre
l'accès à certaines vidéos, la seule solution est de les placer dans
un espace particulier (par exemple un
répertoire distinct), et donc de devoir
changer l'URL
si la classification change. Et, comme le
robots.txt est à la racine du site Web, il
n'est pas sous le contrôle des créateurs de contenu qui ont accès à
un espace dédié mais pas à la totalité du site. Si le CMS que vous
utilisez permet des créations de contenu et des mises à jour
décentralisées, où certaines personnes peuvent modifier une partie
du site, regardez s'il permet à ces personnes d'influencer le
robots.txt. Je suis preneur d'exemples.
Une autre solution (qui ne serait pas forcément exclusive du
robots.txt mais complémentaire) serait
d'inclure les préférences d'utilisation dans le contenu
lui-même. C'est ce que permet l'élément HTML <meta>
ou le format XMP pour les images. Des formats
comme XML
ou JSON
permettraient certainement d'ajouter ces préférences d'utilisation,
qui ont l'avantage de forcément voyager avec le contenu,
contrairement au robots.txt. Évidemment, cela
ne marchera pas si ces métadonnées sont retirées par le programme
de collecte (pas forcément pour des raisons malveillantes, cela peut
être pour diminuer la taille des données). Et certains formats ne se
prêtent pas à cette inclusion des préférences d'utilisation, comme
le texte brut, ou comme les contenus qui ont
plusieurs auteurs (pensez à un fil de discussion sur les réseaux
sociaux).
Une autre solution serait de placer les préférences d'utilisation dans un registre, extérieur aux œuvres, comme cela se fait souvent pour, par exemple, la musique ou les photographies. C'est plus robuste que l'inclusion de métadonnées mais ça passe mal à l'échelle de l'Internet (les registres existants avaient été conçus pour des écosystèmes plus petits et relativement fermés).
Enfin, parmi les difficultés, il faut noter qu'exprimer
préférences et conditions d'utilisation un peu fines nécessite de
disposer d'un vocabulaire (par exemple pour décrire les différentes
techniques qui sont regroupées sous le terme marketing et flou
d'« IA ») et qu'il n'existe pas de vocabulaire standard. Ce serait
une tâche difficile que d'en établir un (un travail est en cours,
dans draft-ietf-aipref-vocab). Je
me souviens d'une réunion IETF où il y avait eu un long débat sur la
question de savoir si la traduction rentrait
dans la catégorie « IA générative » (après
tout, elle génère des textes…).
La section 3 du RFC, en conclusion, essaie de synthétiser et
d'identifier les points sur lesquels l'IETF pourrait
travailler. L'atelier avait un relatif consensus sur le fait que la
situation actuelle est mauvaise et que le principal outil technique
disponible, robots.txt, ne convient pas. Les
pistes de travail discutées ont été :
- Améliorer
robots.txtou bien développer un meilleur système d'attachement aux sites Web, - Définir des attachements pour les protocoles IETF (par exemple dans l'en-tête HTTP, HTML ou XML dépendant d'un autre organisme),
- Définition d'un vocabulaire commun (le groupe de travail IETF aipref y travaille),
- Description de comment les différentes techniques (attachées au site Web ou bien attachées au contenu) se combinent.
Par contre, le consensus était que les points suivants n'étaient pas du ressort de l'IETF ou ne pouvaient pas, pour l'instant, faire l'objet d'un travail concret :
- Faire respecter les directives données aux récoltants (les licences du logiciel libre ont un problème analogue),
- Développer des mécanismes de transparence de la récolte,
- Créer des registres des contenus,
- Identifier et authentifier les bots (à
noter que Cloudflare a lancé cette
idée, ce qui a donné naissance aux brouillons
draft-meunier-web-bot-auth-architectureetdraft-meunier-web-bot-auth-glossary).
Notez qu'un résumé de l'atelier avait été publié juste après. Et, sinon, vous pouvez regarder l'intéressant site Web « Dealing With Bots » et, sur les projets de contrôle de l'accès aux ressources et leurs risques, l'excellent article « No One Should Control the Internet After AI: Freedom to Build Cleopatra GPT ».
L'article seul
RFC 9959: Convergence of Congestion Control from Retained State
Date de publication du RFC : Mai 2026
Auteur(s) du RFC : N. Kuhn (Thales Alenia
Space), E. Stephan
(Orange), G. Fairhurst, R. Secchi
(University of Aberdeen), C. Huitema (Private
Octopus)
Chemin des normes
Réalisé dans le cadre du groupe de travail IETF tsvwg
Première rédaction de cet article le 12 mai 2026
Traditionnellement, les protocoles de transport comme QUIC ou TCP partaient de zéro à chaque connexion. On se connecte, on démarre prudemment (ne pas envoyer trop de données pour éviter de congestionner le réseau), puis on augmente le débit petit à petit. Mais c'est dommage de ne pas tenir compte des connexions précédentes, où on avait déjà suivi ce processus. Ne pourrait-on pas se souvenir des mesures précédentes pour aller plus vite la prochaine fois ? C'est justement ce que propose ce RFC.
Évidemment, si l'idée est simple, la réalisation soulève plein de problèmes, d'autant plus qu'on touche ici à une activité dangereuse : si on se trompe, on risque d'aggraver la congestion. Le RFC détaille donc plus précisément comment réutiliser ces mesures passées, pour ne pas faire s'écrouler le réseau. Tout protocole de transport doit utiliser un algorithme de contrôle de la congestion (RFC 2914) ou bien s'auto-modérer (RFC 8085). Mais concevoir un bon algorithme de contrôle de la congestion n'est pas trivial et, par exemple, le RFC 5783 notait que les algorithmes existants marchaient mal pour les liaisons avec un BDP élevé et/ou très variable, comme les liaisons satellite.
Pour comprendre pourquoi, revenons un peu au fonctionnement typique d'un algorithme de contrôle de la congestion. Il a typiquement deux phases. D'abord, au début de la connexion, on envoie moins de données que ce qu'on pourrait, afin de ne pas congestionner le réseau. Puis on augmente le débit, jusqu'au moment où des indicateurs comme la perte de paquets ou le rythme des accusés de réception (RFC 9406) signalent qu'on a atteint la capacité maximale pour ce flux de données. La dépasser (overshoot) congestionnerait le réseau ou, si les autres flux qui se partagent le réseau sont mieux élevés, entrainerait des diminutions de ressources pour ces autres, voire un écroulement du réseau sous la charge. Voilà pourquoi il faut démarrer lentement.
Au passage, le RFC note que, bien sûr, la connexion TCP ou QUIC qui réutiliserait les mesures d'une précédente connexion doit s'assurer qu'on compare ce qui est comparable : mêmes adresses IP source et destination, et peut-être même DSCP (Differentiated Services Code Point, cf. RFC 2474). On verra plus loin que ce n'est pas suffisant (les choses peuvent changer, le passé peut ne pas être un bon indicateur du présent), mais patientez encore un peu.
La méthode de notre RFC se nomme « reprise prudente » (careful resume) ou, en plus joli « partage temporel » (temporal sharing), puisqu'on reprend des mesures passées (mesures de la capacité, du RTT, etc). Ces mesures pouvant ne plus être d'actualité (trop vieilles et/ou le chemin suivi a changé), il faut en effet être prudent (cf. RFC 9000 et RFC 9040).
Dans quels cas cette reprise (prudente) de données d'une connexion précédente peut être utile ? La section 1.4 du RFC liste un certain nombre de cas d'usages. Entre autres, il y a le cas d'une application qui utilise plusieurs connexions, les connexions peuvent alors utiliser les données récupérées par la première d'entre elles. Ou bien lorsqu'une connexion a été violemment interrompue et repart tout de suite après. Et il y a aussi une autre utilisation, lorsque la latence du chemin utilisé est bien plus importante que dans une liaison Internet typique, ce qui est le cas des satellites lorsqu'ils ne sont pas en orbite basse. L'article « Google QUIC performance over a public SATCOM access » note ainsi que sur une liaison via un satellite géostationnaire, avec l'algorithme classique, transférer 5,3 Mo prendra 9 secondes alors que le partage temporel, si on peut réutiliser les mesures d'une connexion précédente, prendra 4 secondes. (Si les 9 secondes vous semblent trop, compte-tenu de la capacité du lien, rappelez-vous que la capacité n'est pas le seul facteur limitant ; TCP, surtout au démarrage, n'utilise pas toute la capacité, et il met longtemps à converger si la latence est élevée.) Une autre présentation, à l'IETF « Feedback from using QUIC's 0- RTT-BDP extension over SATCOM public access », calcule une réduction du temps de transfert de 62 % pour faire voyager 1 Mo. Enfin, le RFC recommande la lecture de la synthèse « Careful Resumption of Internet Congestion Control from Retained Path State ».
Le récepteur des données peut avoir des informations que l'envoyeur n'a pas, et cela peut le pousser à vouloir désactiver la reprise que l'envoyeur croit prudente. Par exemple, le récepteur sait peut-être quelle quantité de données va être envoyée, ou bien il sait que le chemin sur le réseau a changé.
Toujours pour compliquer les choses, il faut aussi se souvenir que d'autres facteurs peuvent limiter la quantité de données qu'on envoie, par exemple le contrôle de flux, donc les fenêtres de TCP (RFC 9293, section 3.8.6) ou le système de crédit de QUIC (RFC 9000, section 4).
Prenant en compte tout cela, la section 1.5 du RFC résume les principes de la « reprise prudente » :
- D'abord, s'assurer que les conditions n'ont pas changé depuis la dernière connexion ; le chemin est-il le même ? (La mesure du RTT donne une première bonne idée.) À l'issue de cette phase de reconnaissance, si les conditions ont changé, on utilise la méthode classique, on ne tient pas compte des mesures qui ont été sauvegardées.
- Ensuite, OK, on va plus vite qu'avec la méthode classique mais pas aussi vite que ne l'indiquent les mesures sauvegardées. Après tout, la reconnaissance ne permet pas toujours d'identifier un changement dans les conditions.
- Enfin, on se prépare à faire marche arrière, et à revenir à la méthode classique, si on s'aperçoit qu'on est en train de créer de la congestion. (Le RFC note qu'il faut la détecter rapidement, avant que les autres flots de données n'aient détecté la congestion et réduit leur débit.)
Un peu de terminologie avant de continuer (section 2) : le partenaire distant (remote endpoint) est l'ensemble des informations qui identifie à qui on envoie des données, typiquement l'identificateur d'une interface réseau locale couplé à l'adresse IP de la machine avec qui on parle et peut-être (c'est une décision locale, et forcément très dépendante du système d'exploitation utilisé) des informations comme DSCP. Si le partenaire distant change, on en déduit que le chemin a changé (l'inverse n'est pas vrai : le chemin peut changer alors que le partenaire distant est le même). Si on a une indication que le chemin a changé, on revient au mécanisme traditionnel, on n'utilise pas les paramètres gardés des précédentes connexions.
Le mécanisme de notre RFC a donc plusieurs phases (section 3, mais regardez aussi le joli tableau de l'annexe A, qui est peut-être plus clair) : celle de reconnaissance, où on cherche si les caractéristiques du chemin correspondent à un chemin connu, puis , selon son résultat, on passe à la phase dite normale, si on a reconnu un chemin déjà vu, ou bien à la phase non validée (chemin inconnu, on démarre prudemment), puis à la phase de validation (y a t-il un indicateur de congestion ou bien tout est-il beau et propre ?), ou bien à celle de retraite (on jette les informations enregistrées, la situation a changé, on retourne en mode traditionnel), avant de passer à la phase normale. (Des exemples détaillés figurent dans l'annexe B.)
La section 4 du RFC fournit des détails sur la mise en œuvre des principes de ce RFC. Par exemple, la détermination pratique d'un changement du chemin. Un bon indicateur est le RTT. Cette section conseille aussi, même en l'absence d'indications que le chemin a changé, de ne pas garder les paramètres sauvegardés trop longtemps : comme la détection d'un éventuel changement n'est pas parfaite, il vaut mieux avoir une durée de vie maximale pour les paramètres enregistrés. Le RFC suggère quelques heures, voire moins si on sait que le chemin est très dynamique.
Enfin, l'annexe B détaille à l'octet près des exemples de fonctionnement de l'algorithme de reprise prudente, pour différents cas.
Vous pouvez aussi avoir une introduction aux principes de ce RFC dans l'exposé d'un des auteurs à la Journée du Conseil Scientifique de l'Afnic en 2021 (avec les supports).
Merci à Nicolas Kuhn pour sa relecture.
L'article seul
RFC des différentes séries : 0 1000 10000 2000 3000 4000 5000 6000 7000 8000 9000